AI는 세상을 "평균적으로" 본다
LLM은 어떻게 작동하는가? ① 평균과 분포
wonni
MBA, Business School Lausanne (BSL) in Switzerland. AI시대의 Data Analyst이자 AX Builder
AI는 수많은 말뭉치들에 대해 어떤 말이 주로 많이 나오고, 나올 수 있는 말들의 패턴들을 학습하여 인간의 언어로 대화합니다. 즉 평균과 분포가 AI가 작동하는 원리로 활용되는 것입니다.
불과 3~4년 사이에 우리는 AI를 인터넷처럼 쓰게 되었습니다. 예전에는 검색창에 검색어를 넣고, 수십 페이지에 걸친 결과를 뒤져 원하는 정보를 찾았습니다. 지금은 "무엇을 도와드릴까요?"라는 문구와 함께 깜박이는 입력창에 그냥 질문합니다. 그러면 AI는 정보를 찾아주는 데서 그치지 않고, 분석하고 가공해서 제가 원하는 형태의 결과물로 만들어 줍니다.
AI 입력창에 질문하는 것이 검색을 대신하게 되었습니다. (Unsplash, Aerps.com)
그래서 "인터넷에 검색해 봐"라는 말이 "AI한테 물어봐"로 바뀌었습니다. 회사에서도, 집에서도, 학교에서도 그렇습니다. 그런데 이렇게 매일 쓰다 보면 한 번쯤 궁금해집니다. 도대체 AI는 어떻게 사람의 말을 알아듣는 걸까요. 어떻게 질문을 이해하고 문제를 푸는 것처럼 보이는 걸까요.
요즘 우리가 쓰는 AI는 거의 다 LLM을 기반으로 작동합니다. LLM은 Large Language Model의 약자로, 우리말로는 거대 언어 모델 또는 대규모 언어 모델이라고 합니다. 저는 이 LLM이 무엇이고 어떤 원리로 돌아가는지를, 개발자나 수학자가 아니어도 따라올 수 있게 한 개념씩 풀어 보려고 합니다. 그 첫 번째가 평균과 분포입니다.
먼저 보는 핵심
ChatGPT, Gemini, Claude, Grok 같은 AI는 모두 LLM 위에서 돌아갑니다. LLM이 하는 일은 한 줄로 이렇게 요약할 수 있습니다.
"글을 숫자로 바꾸고 → 수많은 곱셈·덧셈으로 '다음에 올 토큰(글자 조각)의 확률'을 계산하고 → 그중 하나를 골라 뒤에 붙인다." 이 일을 문장이 끝날 때까지 반복하는 것이 전부입니다.
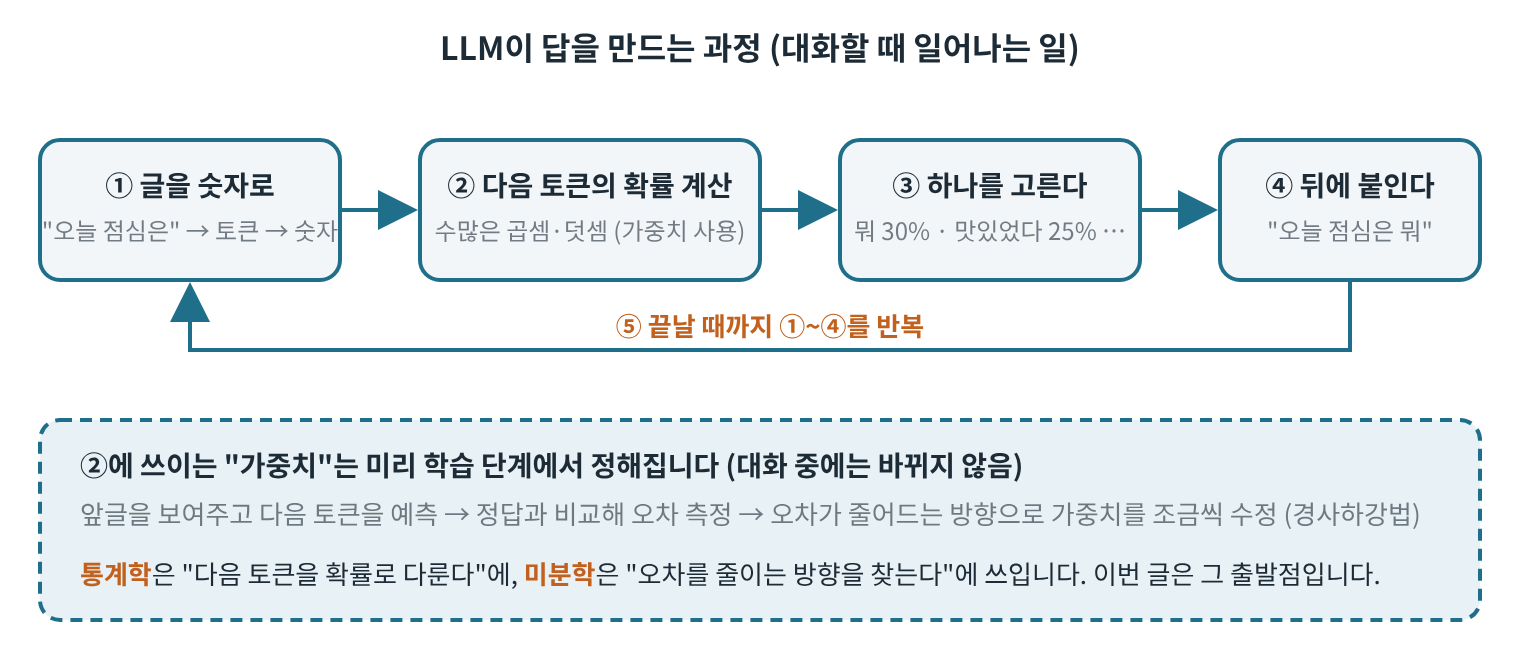
그림 0. LLM이 답을 만드는 과정. 대화 중에는 ①~④를 반복할 뿐이고, ②에 쓰이는 가중치는 미리 학습 단계에서 정해집니다.
이 확률 계산에는 엄청나게 많은 숫자(가중치)가 쓰입니다. 이 숫자들은 사람이 정한 것이 아닙니다. AI를 세상에 내놓기 전 학습 단계에서 정해집니다. 학습 단계에서는 LLM에게 글의 앞부분을 보여 주고 다음 토큰을 예측하게 한 뒤, 실제 정답과 비교해 틀린 정도(오차)를 잽니다. 그 다음 미분을 이용해 "각 가중치를 어느 방향으로 바꾸면 오차가 줄어드는지"를 계산하고, 그 방향으로 가중치를 아주 조금씩 고칩니다. 이것을 경사하강법이라고 부릅니다. 이 과정을 수조 개의 토큰에 걸쳐 반복하면 가중치는 점점 다음 토큰을 잘 맞히는 값으로 다듬어집니다.
정리하면 통계학은 "다음 토큰을 확률로 다룬다"는 부분에, 미분학은 "오차를 줄이는 방향을 찾는다"는 부분에 쓰입니다. 그리고 가중치를 고치는 일은 학습 단계에서만 일어납니다. 우리가 AI와 대화할 때는 이미 다듬어진 가중치로 확률을 계산하기만 합니다.
이 원리를 모른 채 쓰면 AI가 내놓는 답을 모두 정답으로 받아들이기 쉽습니다. 그래서 "LLM은 어떻게 작동하는가"라는 주제로 글을 이어 가려고 합니다. 이번 글의 결론을 먼저 말하면 이렇습니다. AI는 세상을 본 것이 아니라 "인터넷 글의 분포"를 배웠고, 그 분포에서 가장 흔한 쪽으로 기울어 있습니다. 그럼 이제 이 문장이 무슨 뜻인지, 이제 하나씩 풀어 보겠습니다.
전학생과 일기예보: 평균과 분포의 감각
"ChatGPT나 Claude는 어떻게 '보통 사람이 할 법한 말'을 그렇게 자연스럽게 할까?" AI를 쓰면서 한 번쯤 떠올렸을 질문입니다. AI에게 "오늘 기분이 좀 안 좋아"라고 쓰면 대개 "무슨 일 있었어? 이야기해 줄래?" 같은 말이 돌아옵니다. 누가 가르쳐 준 것도 아닌데 어떻게 그 상황에 어울리는 말을 고를까요.
"오늘 기분이 좀 안 좋아"라고 입력하면 AI는 어떻게 어울리는 말을 고를까요. (Unsplash, Zulfugar Karimov)
답은 생각보다 단순합니다.
AI는 엄청나게 많은 글을 보면서 "이런 상황에서는 보통 이런 말이 온다"는 패턴을 배웠습니다. 그 "보통"을 숫자로 다루는 가장 기본적인 도구가 평균이고, "보통에서 벗어나는 경우는 얼마나 자주, 얼마나 멀리 있는가"까지 담은 전체 그림이 분포입니다.
둘 다 중·고등학교에서 배우는 내용입니다. 다만 이 두 가지가 AI를 이해하는 첫 번째 열쇠라는 사실은 잘 알려져 있지 않습니다.
학창 시절의 흔한 장면으로 비유해 보겠습니다. 새 학교에 전학 온 첫날, 반 분위기를 빨리 파악하려면 어떻게 할까요. 며칠 동안 친구들을 관찰합니다. 점심시간에 뭘 먹는지, 쉬는 시간에 무슨 얘기를 하는지, 선생님이 질문하면 보통 누가 대답하는지. 며칠 뒤에는 이렇게 말할 수 있게 됩니다. "우리 반은 보통 급식 먹고, 가끔 매점 가." 이것이 평균적인 감각입니다.
그런데 관찰력이 좋은 전학생은 한 가지를 더 압니다. "급식은 다들 먹는데, 매점 가는 건 거의 세 명이 전부야." 보통이 무엇인지만이 아니라 얼마나 다양한지, 어떤 경우가 드문지까지 아는 것입니다. LLM이 하는 일이 이것과 닮았습니다. 다만 관찰 대상이 반 친구 20~30명이 아니라 인터넷에 있는 수조 개의 글 조각이라는 점이 다릅니다.
또 하나는 일기예보입니다. 10월 초 서울의 낮 기온은 "평년 22도쯤"이라고 합니다. 이 숫자 하나로도 옷차림을 대충 정할 수 있습니다. 그런데 어떤 해는 28도까지 오르고 어떤 해는 15도로 떨어집니다. 그래서 기상청은 평년값만이 아니라 "평년보다 높겠다", "일교차가 크겠다" 같은 흩어짐에 관한 정보를 함께 줍니다. 평균만 믿고 반팔을 입고 나갔다가 추위에 떨 수 있기 때문입니다.
AI도 마찬가지입니다. "이 상황에서 가장 흔한 말"만 알아서는 부족합니다. "이런 말도 종종 온다", "이런 말은 거의 안 온다"까지 알아야 자연스러운 글이 나옵니다. 이것이 평균만이 아니라 분포 전체를 배워야 하는 이유입니다.
평균이 같아도 분포는 다를 수 있다
그렇다면 평균이 같으면 분포도 같을까요. 그렇지 않습니다. 평균 키가 똑같이 160cm인 두 반이 있다고 해 봅시다. A반 학생들의 키는 158, 159, 160, 160, 161, 162이고, B반은 150, 154, 158, 162, 166, 170입니다. 더해서 나눠 보면 두 반 모두 평균은 160cm입니다.
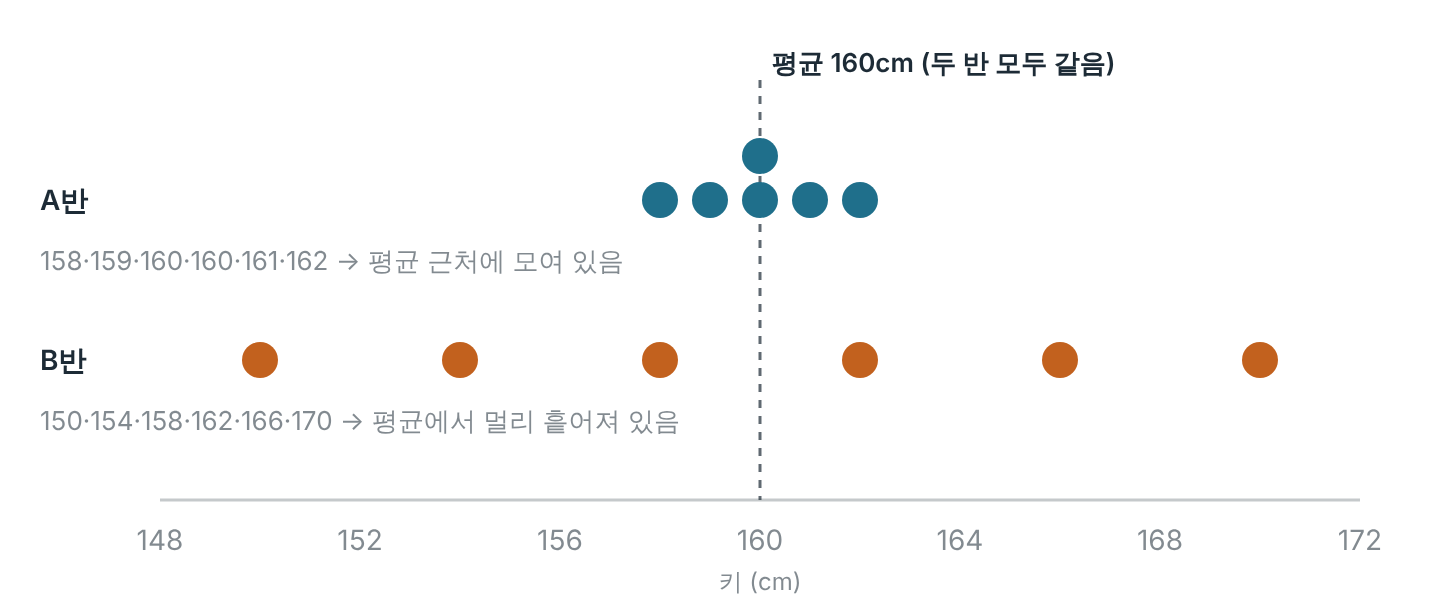
그림 1. A반은 평균 근처에 촘촘히 모여 있고, B반은 150cm부터 170cm까지 넓게 퍼져 있습니다. "평균"만 들으면 두 반이 똑같아 보이지만 실제 모습은 전혀 다릅니다.
이 "흩어진 정도"를 숫자로 잡는 가장 쉬운 방법은 각자가 평균에서 얼마나 떨어져 있는지를 다시 평균 내는 것입니다. 신발 사이즈로 해 보겠습니다. 세 친구의 신발 사이즈가 240, 250, 260이면 평균은 750 ÷ 3 = 250입니다. 다른 세 친구가 230, 250, 270이어도 평균은 똑같이 250입니다. 그런데 느낌은 다르지요.
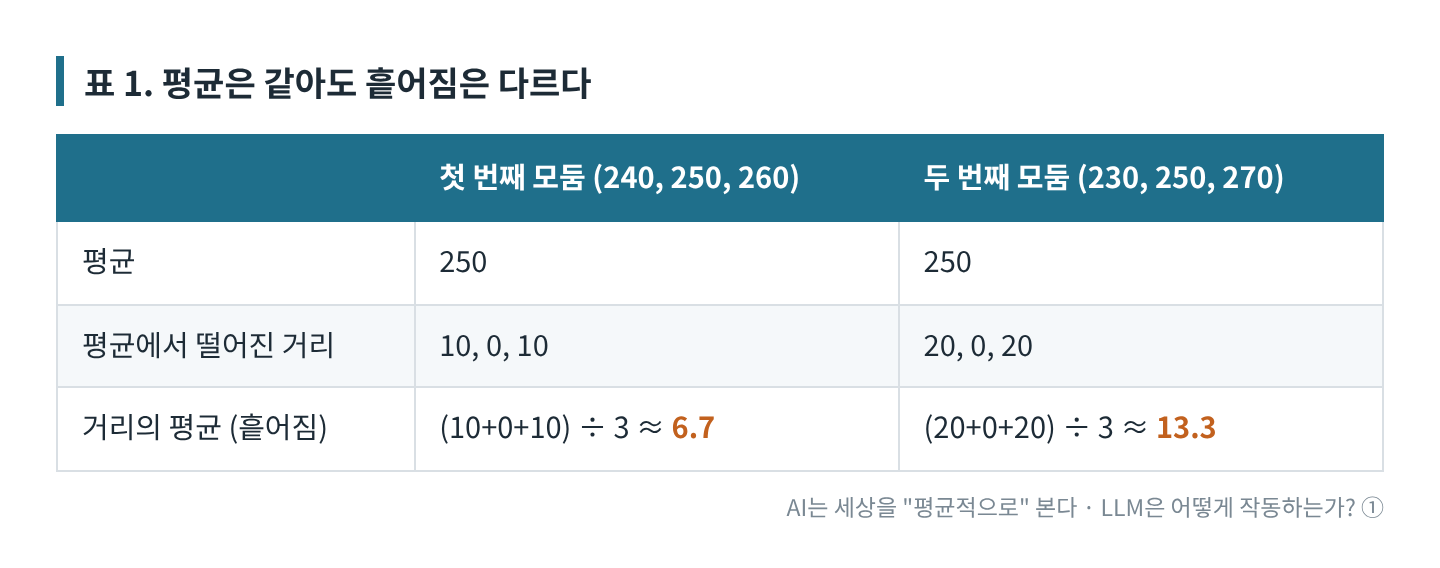
두 번째 모둠이 두 배쯤 더 흩어져 있다는 것이 숫자로 드러납니다. 통계학에서는 이것을 조금 다르게 계산한 표준편차라는 값을 주로 씁니다. 계산 방식은 약간 다르지만 "평균에서 보통 얼마나 떨어져 있는가"를 잰다는 뜻은 같습니다. 지금은 이름만 알아 두면 충분합니다.
분포란 무엇인가: "오늘 점심은" 뒤에 오는 단어
이제 키나 신발 사이즈 대신 단어로 넘어가 보겠습니다. AI가 어떤 표현 뒤에 올 단어를 맞히기 위해 글을 분석했다고 가정해 봅시다. 가상의 글 1,000문장에서 "오늘 점심은" 뒤에 어떤 단어가 왔는지 세어 보았더니 다음과 같았다고 합시다.
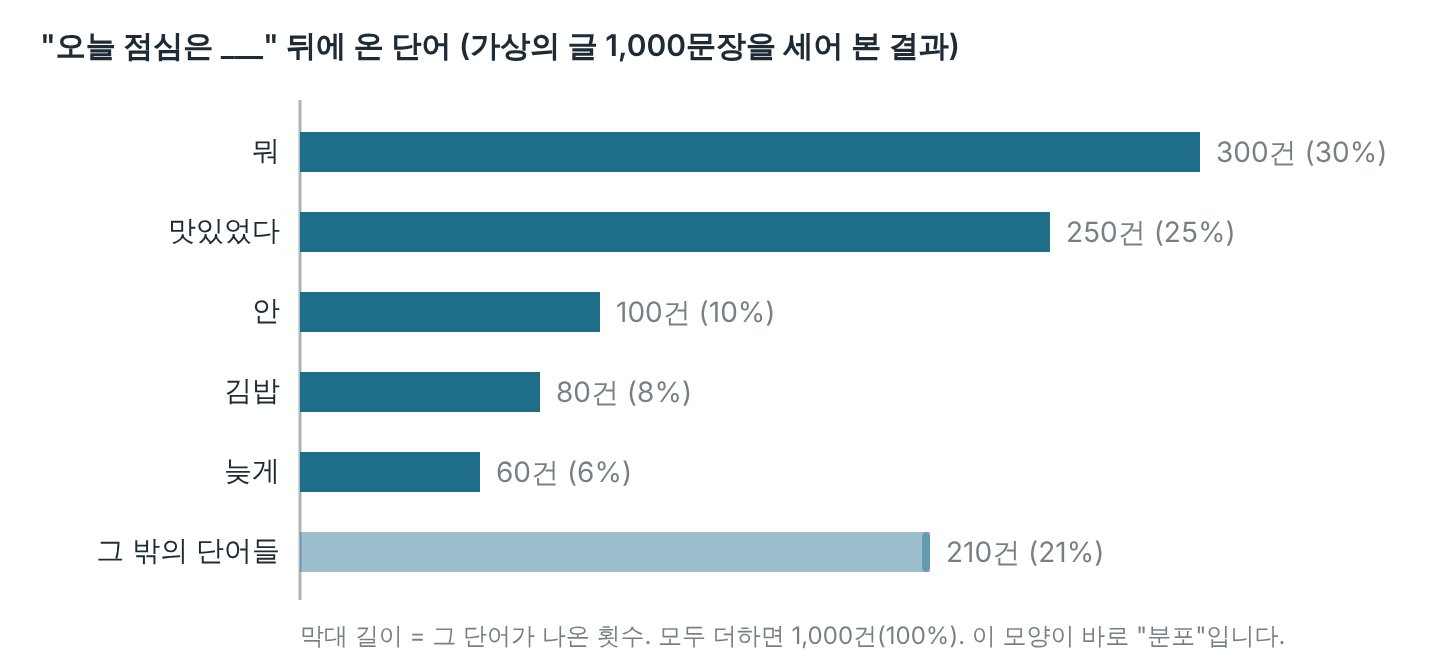
그림 2. "오늘 점심은" 뒤에 온 단어를 센 결과. "뭐"가 가장 흔하고 "늦게"는 드뭅니다. 이렇게 각 경우가 몇 번씩 나왔는지 늘어놓은 모양을 분포라고 부릅니다. (숫자는 설명을 위해 만든 예시입니다.)
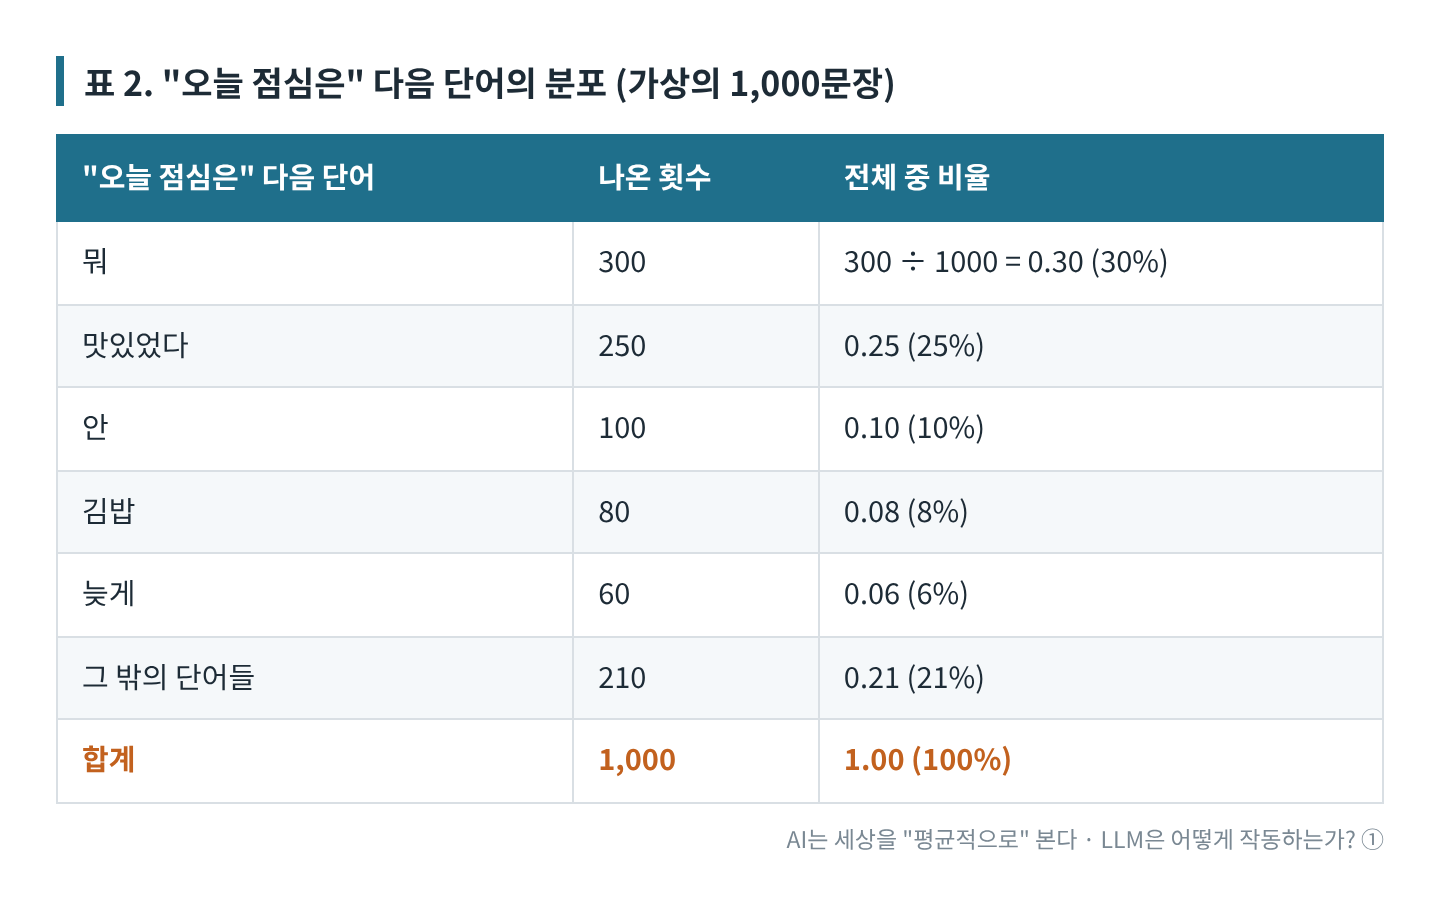
비율을 모두 더하면 꼭 1(100%)이 됩니다. 이 "비율"이 다음 회차 글에서 다룰 확률이 됩니다. 그리고 이 표를 보면 어떤 단어가 흔하고 어떤 단어가 좀처럼 나오지 않는지 알 수 있습니다. 여기서는 한 가지만 기억하면 됩니다.
"분포를 안다 = 어떤 경우가 흔하고 어떤 경우가 드문지 안다."
숫자를 늘어놓아 모양으로 보면, 흔한 것과 드문 것이 한눈에 보입니다. (사진: Unsplash, Luke Chesser)
단어에는 평균이 없다: 그래서 중요한 최빈값
여기서 꼭 짚고 갈 것이 있습니다. 키나 신발 사이즈는 숫자라서 평균을 낼 수 있습니다. 그런데 "뭐", "맛있었다", "김밥"의 평균은 무엇일까요. 더할 수도 나눌 수도 없습니다. 단어에는 평균이 없습니다. 그래서 통계학에는 "대표하는 값"을 고르는 방법이 평균 말고도 더 있습니다.
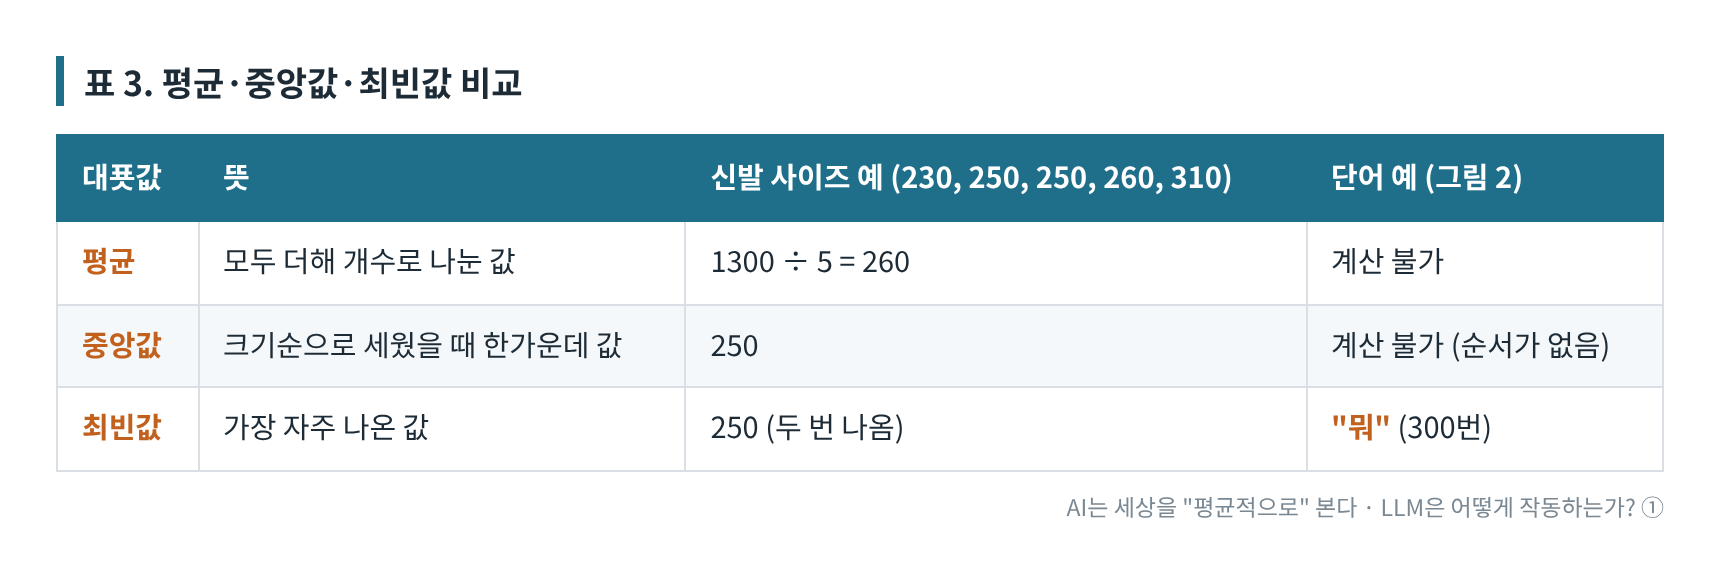
신발 사이즈 예를 보면 310이라는 큰 값 하나 때문에 평균이 260으로 끌려 올라갔지만, 실제로 가장 많은 친구가 신는 것은 250입니다. 극단적인 값이 하나 섞이면 평균은 쉽게 흔들리고, 중앙값과 최빈값은 잘 흔들리지 않습니다.
단어처럼 더하거나 줄 세울 수 없는 것에서는 최빈값, 즉 "가장 흔한 것" 만이 대푯값이 됩니다. 이 글의 제목 "AI는 세상을 평균적으로 본다"에서 "평균적"이라는 말은 사실 이 뜻에 가깝습니다. 수학적으로 더 정확히 말하면 "AI는 가장 흔한 것으로 기울어 있고, 흔한 정도에 따라 나머지도 알고 있다" 입니다.
표본: AI가 본 것은 세상이 아니라 인터넷 글이다
그러면 앞서 들었던 예시들을 통해 AI가 바라보는 데이터들의 집합에 대해 수학적 개념인 **"표본"**으로 이야기해보겠습니다.
전학생이 관찰한 것은 우리 반이지 전국의 학생이 아닙니다. 우리 반 평균 키가 160cm라고 해서 전국 평균이 160cm라고 말할 수는 없습니다. 통계학에서는 실제로 관찰한 일부를 표본, 알고 싶은 전체를 모집단이라고 부릅니다. 표본에서 얻은 분포가 전체를 잘 대표하려면 표본이 전체를 골고루 담고 있어야 합니다.
표본이 한쪽으로 치우치면 어떻게 될까요. 어느 학교 학생 전체의 평균 키가 162cm라고 합시다. 그런데 조사하는 사람이 마침 농구부 교실 앞을 지나다가 거기 있던 다섯 명만 쟀다면 어떻게 될까요. 178, 180, 182, 185, 190을 더해 5로 나누면 평균 183cm가 나옵니다.
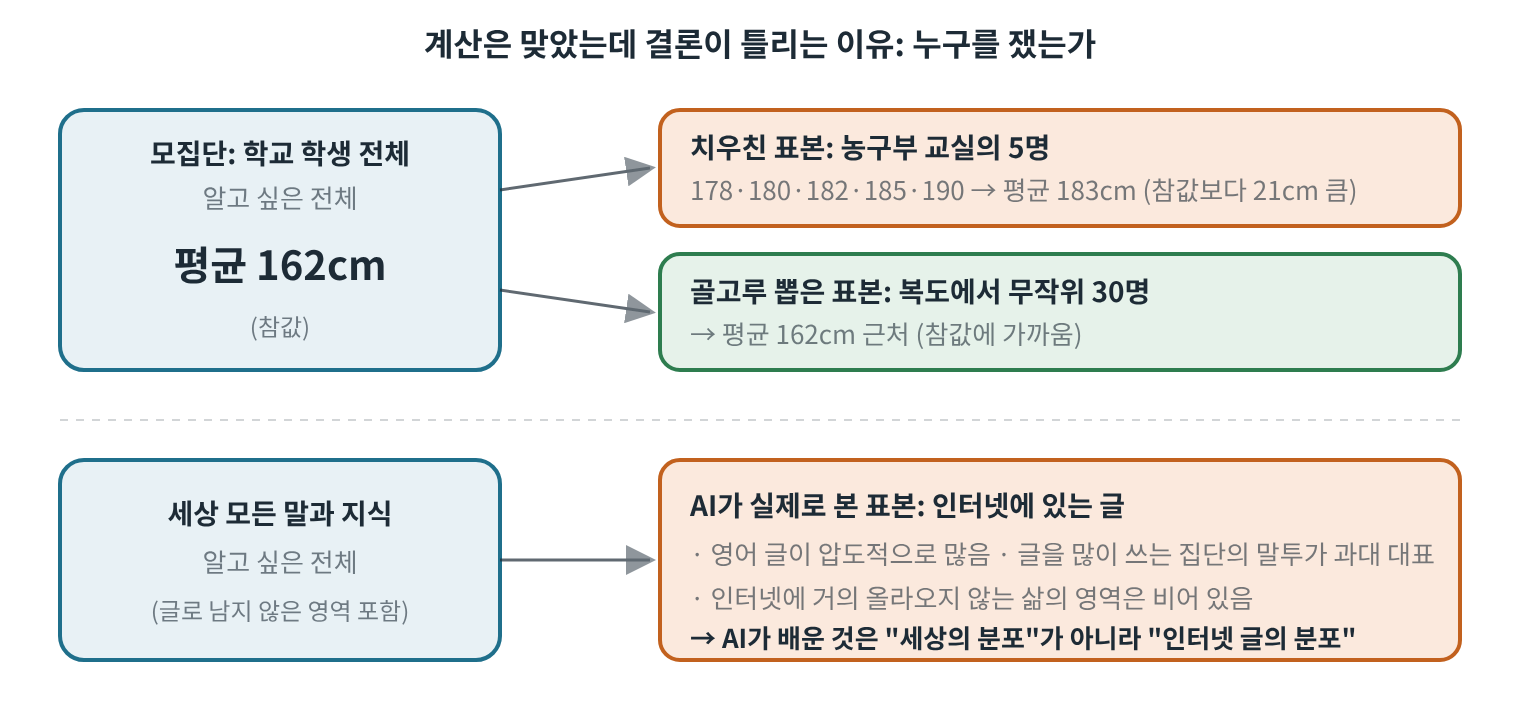
그림 3. 계산은 한 군데도 틀리지 않았는데 결론이 21cm나 틀렸습니다. 잘못은 계산이 아니라 "누구를 쟀는가"에 있습니다. AI가 배운 인터넷 글도 같은 문제를 안고 있습니다.
"이 학교 학생의 평균 키는 183cm"라고 발표하면 실제보다 21cm나 큰, 완전히 틀린 결론이 됩니다. 이것을 표본의 편향이라고 합니다. 반대로 복도에서 마주치는 학생을 무작위로 서른 명 쟀다면 162cm에 훨씬 가까운 값이 나왔을 것입니다.
표본의 크기보다 표본을 어떻게 골랐는가가 먼저라는 것이 통계학의 오래된 교훈입니다.
AI가 관찰한 글도 표본입니다. 그런데 인터넷에 있는 글은 세상 모든 말이 골고루 섞인 표본이 아닙니다. 영어로 쓰인 글이 압도적으로 많고, 글을 많이 쓰는 사람과 거의 쓰지 않는 사람이 있고, 인터넷에 올라오지 않는 삶의 영역도 많습니다. 우리 회사 내부 사정, 우리 동네 골목 식당, 어제 있었던 일 같은 것들입니다. 따라서 AI가 배운 분포는 "세상의 분포"가 아니라 "인터넷 글의 분포" 입니다. 이 차이를 기억하면 AI의 많은 특징이 설명됩니다.
단어의 세상은 극단적으로 치우쳐 있다: 지프 법칙
그렇다면 이 "인터넷 글의 분포"는 어떤 모양일까요. 연구자들이 오래전부터 관찰해 온 사실이 있습니다.
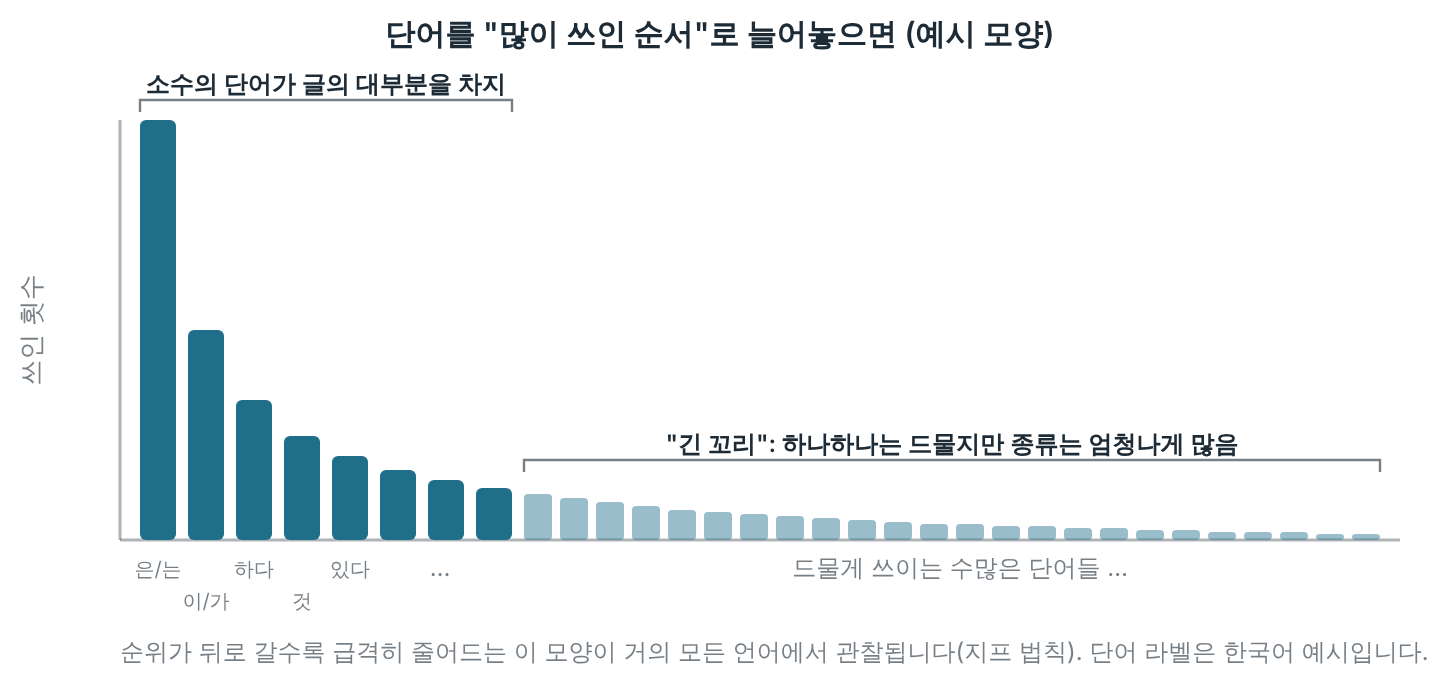
어떤 언어든 글에 쓰인 단어를 세어 보면, 아주 자주 쓰이는 소수의 단어가 글 전체의 대부분을 차지하고, 나머지 수많은 단어는 아주 드물게만 쓰입니다.
영어라면 "the", "a", "I" 같은 단어 몇 개가 큰 몫을 차지하고, 한국어라면 "은/는", "이/가", "하다" 같은 말이 그렇습니다. 이 규칙성은 발견자의 이름을 따 지프 법칙(Zipf's law) 이라고 부릅니다.
그림 4. 단어를 "많이 쓰인 순서"로 세워 보면 앞쪽 몇 개가 글의 대부분을 차지하고, 뒤로는 드물게 쓰이는 단어가 끝없이 이어집니다. 이 "긴 꼬리" 모양은 AI가 무엇을 잘하고 무엇을 못하는지와 직접 관련이 있습니다.
감을 잡아 봅시다. 어떤 책에서 가장 많이 쓰인 단어가 1,000번 나왔다면, 두 번째로 많이 쓰인 단어는 대략 500번(절반), 세 번째는 약 333번(3분의 1), 열 번째는 약 100번(10분의 1)쯤 나오는 식으로 순위가 뒤로 갈수록 급격히 줄어듭니다. 1,000번째 단어는 한 번쯤밖에 안 나옵니다. 그런데 그런 "한 번쯤 나오는 단어"의 종류는 엄청나게 많습니다. 이것이 "긴 꼬리"입니다.
이 모양은 AI에게 두 가지를 뜻합니다. 첫째, 흔한 단어와 흔한 표현은 수없이 많이 관찰되므로 아주 정확하게 배워집니다. 둘째, 꼬리 쪽에 있는 드문 단어, 드문 표현, 드문 주제는 몇 번 보지 못했으므로 엉성하게 배워집니다. 전학생이 "매점 가는 세 명" 중 한 명이 뭘 사 먹는지까지는 잘 모르는 것과 같습니다.
상황이 바뀌면 분포도 바뀐다
여기서 하나 더 생각해 봅시다. AI는 "오늘 점심은" 뒤에 올 단어만 맞히는 것이 아닙니다. "오늘 점심은" 뒤의 단어 분포와 "어제 저녁에 할머니 댁에서" 뒤의 단어 분포는 당연히 다릅니다. 앞의 글이 바뀌면 뒤에 올 단어의 분포도 바뀝니다.
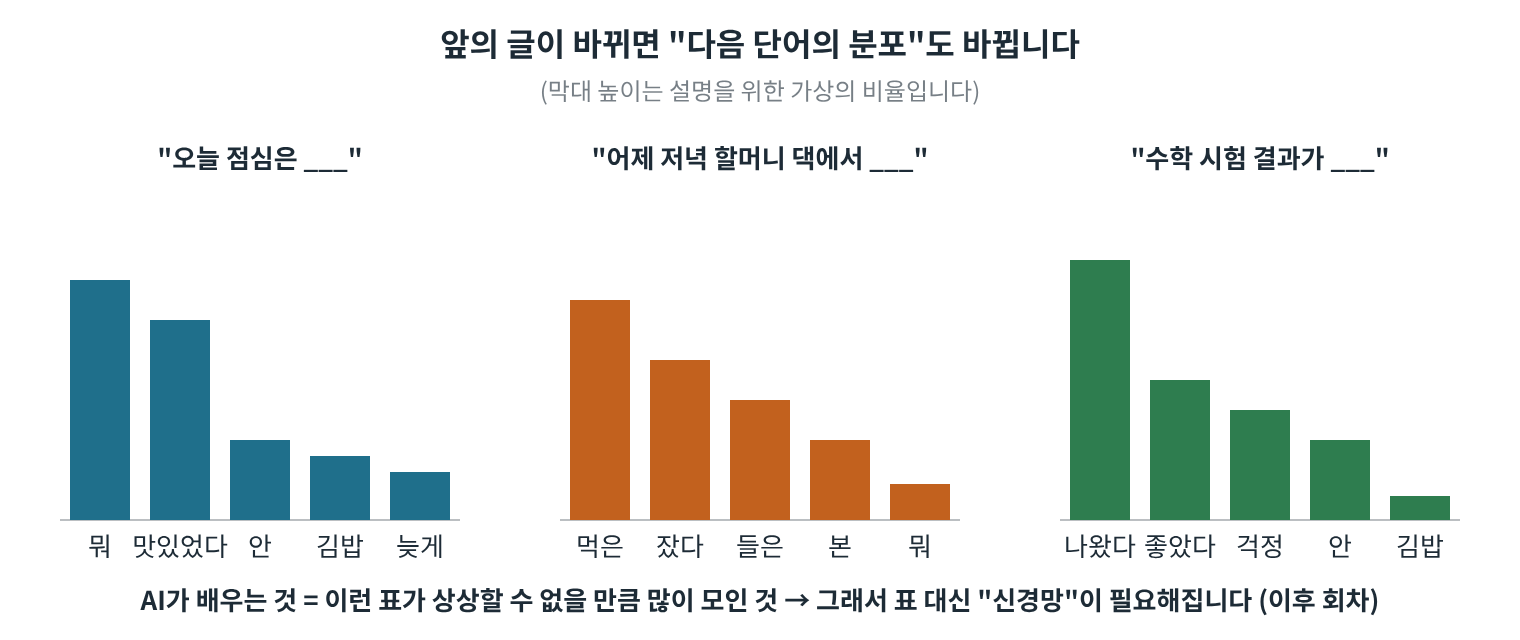
그림 5. 앞의 글에 따라 "다음 단어의 분포"가 달라집니다. AI가 배우는 것은 이런 분포가 상상할 수 없을 만큼 많이 모인 데이터 모음인 것입니다.
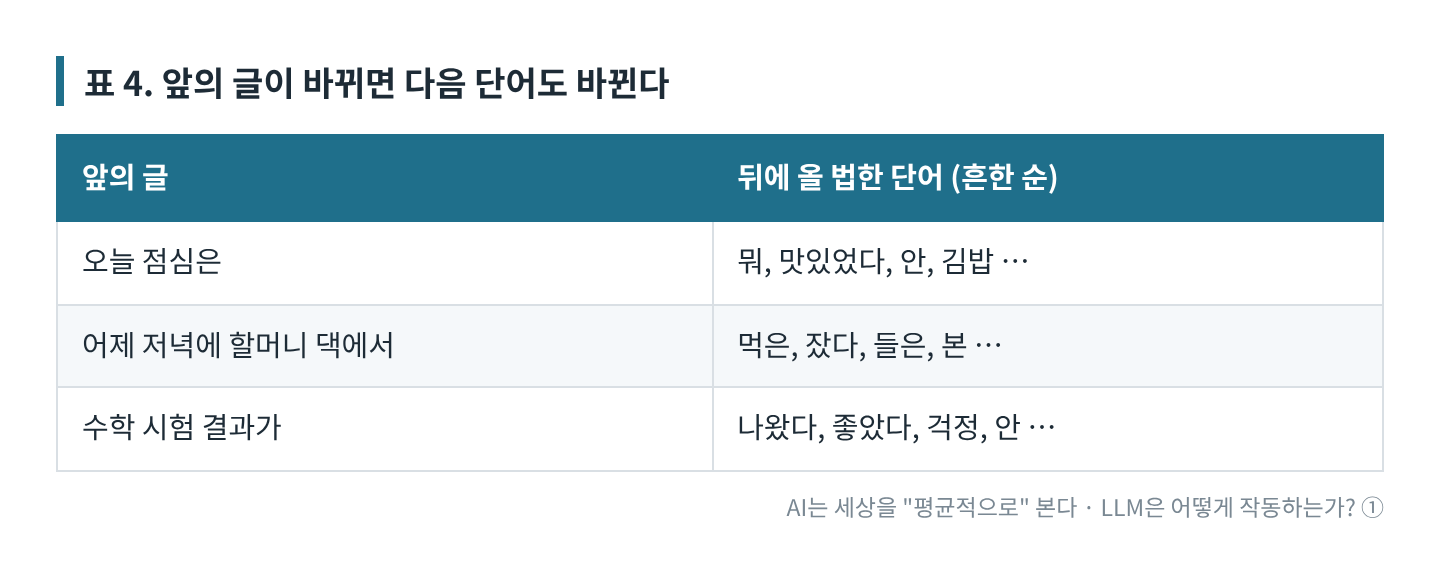
그래서 AI가 배우는 것은 분포 하나가 아니라, "앞의 글이 이럴 때 뒤의 분포는 이렇다"는 분포들의 거대한 모음입니다.
앞의 글은 무한히 다양하므로 이런 표를 실제로 다 만들어 둘 수는 없습니다. 그래서 신경망이라는 다른 방법이 필요해지는데, 그 이야기는 이후 회차에서 다루겠습니다. 지금은 "상황이 바뀌면 분포도 바뀐다"는 감각만 가져가도 충분합니다.
이렇게 "이 앞의 글 다음에는 어떤 글자 조각이 얼마나 자주 오는가"라는 분포를 배우는 모델을 언어 모델이라고 부릅니다. ChatGPT, Gemini, Claude, Grok, DeepSeek은 모두 이 언어 모델을 아주 크게 만든 것, 즉 대규모 언어 모델입니다.
70년 전에 시작된 발상
이 대규모 언어 모델의 발상은 새로운 것이 아닙니다. 1951년 정보이론의 창시자 클로드 섀넌은 사람에게 영어 문장을 한 글자씩 가린 채 보여 주고 다음 글자가 무엇일지 맞히게 하는 실험을 했습니다. 틀리면 다시 맞히게 하면서 몇 번 만에 맞히는지를 기록했는데, 사람들은 생각보다 훨씬 자주 첫 시도에 맞혔습니다. "th" 다음에는 "e"가, "q" 다음에는 "u"가 올 것을 우리는 거의 확신하기 때문입니다.
섀넌은 이 실험으로 글이 상당히 예측 가능한 통계적 구조를 가진다는 것을 보였습니다.
오늘날 LLM이 하는 일은 이 "다음 글자 맞히기"를 사람 대신 기계가, 영어 한 언어가 아니라 수십 개 언어와 프로그래밍 언어까지, 그리고 상상하기 어려운 규모의 글 위에서 하는 것이라고 요약할 수 있습니다. 2003년 캐나다의 요슈아 벤지오 연구팀은 이 "다음 단어의 분포"를 신경망으로 배우게 하는 방법을 제안했는데, 오늘날 LLM은 이 계보 위에 있습니다.
실제 AI는 얼마나 많은 글을 보았을까
그렇다면 우리가 쓰는 AI는 실제로 얼마나 많은 글을 학습할까요. 공개된 정보만으로 이야기하겠습니다. 중국 DeepSeek의 V3 모델은 기술 보고서에서 14.8조 개의 토큰(글자 조각) 위에서 사전학습했다고 밝혔습니다. 사람이 1초에 토큰 하나씩 쉬지 않고 읽는다고 해도 약 47만 년이 걸리는 양입니다. "엄청나게 많은 글을 관찰했다"는 말이 과장이 아닙니다.
또한, AI가 사전학습하면서 중요한 부분이 학습하는 표본의 편향을 줄이는 것입니다. 표본의 편향, 그중에서도 "인터넷 글은 영어에 치우쳐 있다"는 문제는 실제로 모든 AI 개발사들이 고민하는 지점이며, 편향을 줄이고 있습니다. 예를 들어, 한국 NAVER의 HyperCLOVA X 기술 보고서는 한국어와 한국 문화에 맞추어 학습 데이터를 구성했다고 밝히고 있습니다. 분포가 엉성한 영역(한국어)의 표본을 의도적으로 두텁게 만든 것이라고 볼 수 있습니다.
그래서 AI는 이런 성격을 갖게 됩니다
이렇게 "인터넷 글의 분포를 배웠다"는 사실에서 AI의 성격 몇 가지가 자연스럽게 따라 나옵니다. (※ 각 AI 모델이 실제로 어느 정도 그런지는 모델과 버전마다 다르다는 점을 말씀드립니다.)
1. 흔한 것을 잘하고 드문 것을 못합니다. 인터넷에 글이 많은 주제(영어, 프로그래밍, 유명한 역사)는 분포가 촘촘하게 메워졌고, 글이 적은 주제(소수 언어, 아주 최근 일, 특정 동네 맛집, 우리 회사 내부 사정)는 분포가 엉성합니다. 그림 4의 긴 꼬리가 바로 이것입니다.
2. "가장 흔한 답"으로 끌립니다. 최빈값 쪽으로 기우는 경향이 있어서 무난하고 평균적인 글이 나오기 쉽습니다. 보고서 초안을 AI에게 맡겼을 때 "어디서 본 듯한" 글이 나오는 이유이기도 합니다. 물론 드문 쪽을 일부러 고르게 할 수도 있는데, 이는 다른 회차에서 다루겠습니다.
3. 분포가 엉성한 곳에서 그럴듯한 거짓이 나옵니다. 드물게 본 주제에서도 AI는 "흔한 모양의 글"을 만들어 내므로, 내용은 틀렸는데 형식은 자연스러운 글이 나올 수 있습니다. 이것이 "환각"의 씨앗입니다. 환각에 대해서도 이후에 제대로 다루겠습니다.
4. 인터넷의 치우침을 물려받습니다. 표본 편향 때문에, 인터넷에 글을 많이 남긴 집단의 말투와 관점이 더 "보통"으로 배워질 수 있습니다. 각 개발사는 이를 줄이려는 추가 학습을 하는데, 그 방법은 차후에 다루겠습니다.
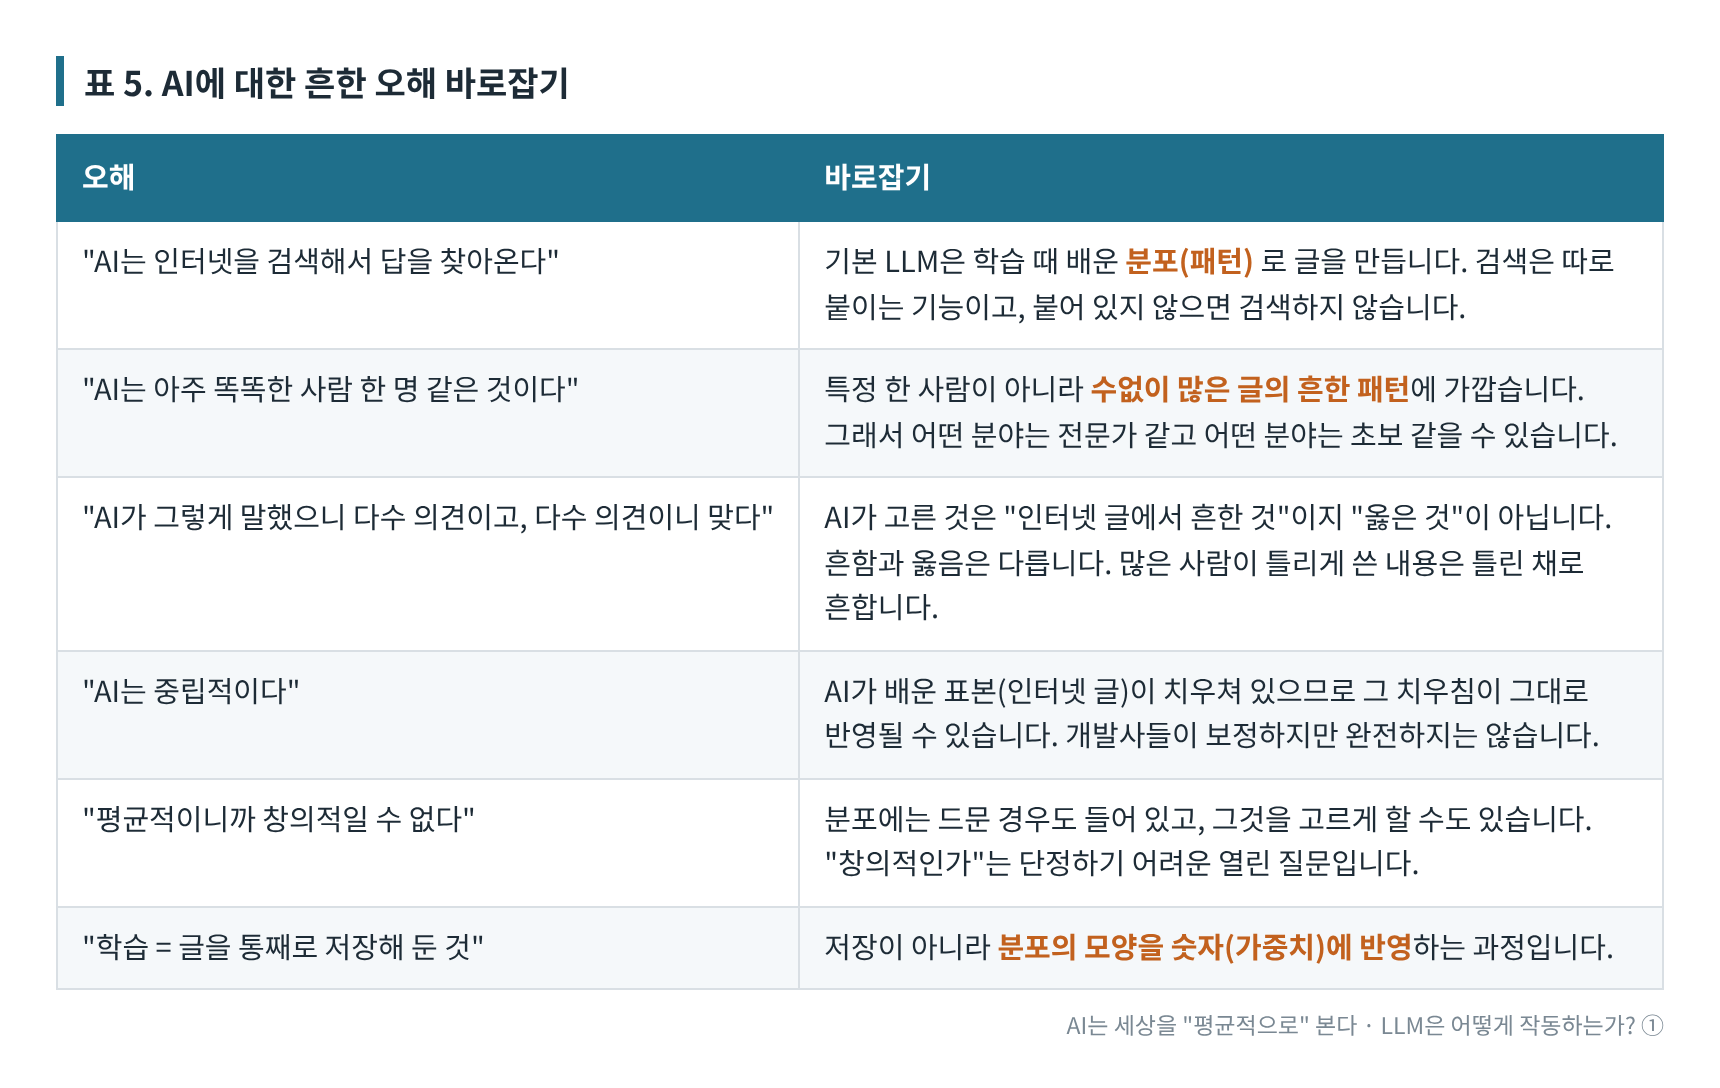
흔한 오해 바로잡기
그래서 이제 우리는 평균과 분포라는 개념만으로도 AI에 대해 흔히 하는 오해 몇 가지를 바로잡을 수 있습니다.
AI는 똑똑한 사람 한 명이 아니라, 수많은 글의 흔한 패턴에 가깝습니다. (사진: Unsplash, Mohamed Nohassi)
핵심 세 문장
이렇게 평균과 분포라는 수학적 개념이 AI에 어떻게 활용되고 있는지 알아보았습니다. 핵심을 정리하면 다음과 같습니다.
-
평균은 "보통"을, 분포는 "보통과 그 바깥까지 전부"를 보여 줍니다. 평균이 같아도 분포는 전혀 다를 수 있습니다.
-
AI가 배운 것은 "인터넷 글"이라는 표본의 분포입니다. 세상의 분포도, 옳은 것의 분포도 아닙니다.
-
단어의 분포는 극단적으로 치우쳐 있어서, AI는 흔한 것을 아주 잘하고 드문 것을 엉성하게 합니다. 그리고 가장 흔한 것(최빈값) 쪽으로 기웁니다. "AI는 세상을 평균적으로 본다"는 말의 정확한 뜻이 이것입니다.
다음 글에서는 이 글의 "비율"이 어떻게 확률이 되고, AI가 그 확률로 다음 글자 조각을 고르는지 함께 알아보겠습니다.
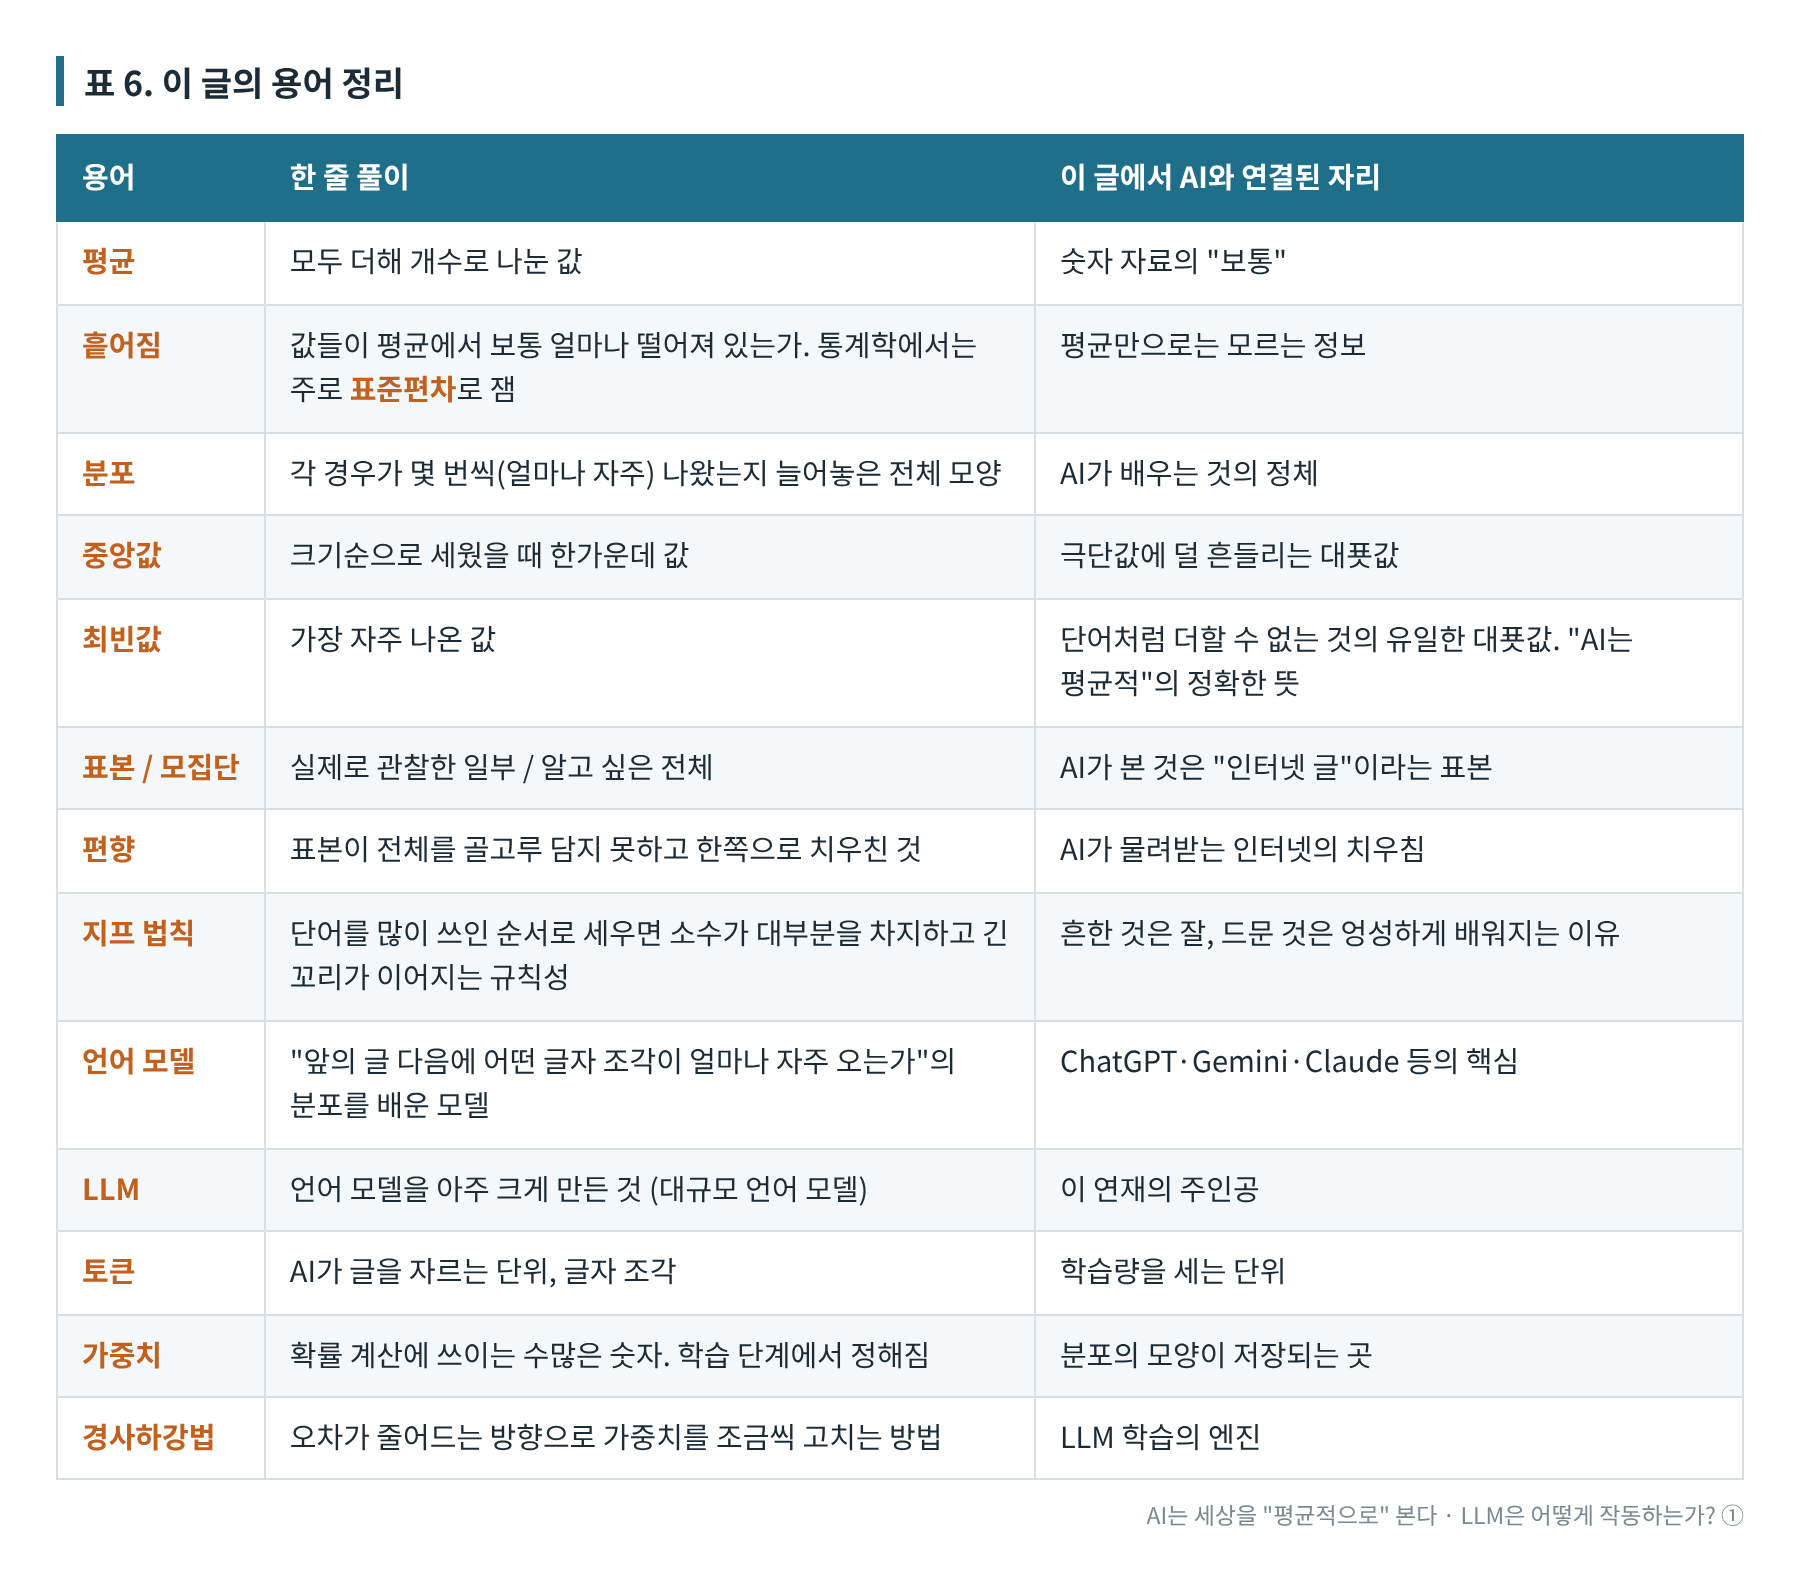
이 글의 용어 정리
출처 정보
-
OpenStax, Introductory Statistics 2e
-
OpenStax, Introductory Statistics 2e, 1.2 Data, Sampling, and Variation in Data and Sampling
-
S. T. Piantadosi, Zipf's word frequency law in natural language: A critical review and future directions, Psychonomic Bulletin & Review, 2014
-
C. E. Shannon, Prediction and Entropy of Printed English, Bell System Technical Journal, 1951
-
Y. Bengio, R. Ducharme, P. Vincent, C. Jauvin, A Neural Probabilistic Language Model, Journal of Machine Learning Research 3, 2003
-
DeepSeek-AI, DeepSeek-V3 Technical Report, 2024
-
NAVER Cloud HyperCLOVA X Team, HyperCLOVA X Technical Report, 2024
Newsletter
이런 노트를 이메일로 받아보세요
새로운 리서치 노트가 발행되면 가장 먼저 알려드립니다.