AI의 아버지 - "확률", 더 이상 어렵지 않다.
LLM은 어떻게 작동하는가? ② 확률
wonni
MBA, Business School Lausanne (BSL) in Switzerland. AI시대의 Data Analyst이자 AX Builder

AI는 수많은 글(텍스트)들의 분포속에서 각 글(토큰)의 출현 비율을 확률로 삼아, 나타낼 글을 선택합니다. 그렇게 "앞의 글이 주어졌을 때 다음 토큰의 확률"을 계산하고, 그 확률에 따라 토큰 하나를 고르고, 붙이고, 반복합니다. 그리고 이러한 과정을 반복하여 글을 만들어 내는 것입니다. 그러나 출현 비율이 가장 높은 단어가 매번 나오는 것은 아닙니다. 온도 조절을 통해 가장 적절한 단어가 나오도록 하기 때문입니다.
지난 글 「AI는 세상을 "평균적으로" 본다」를 통해 우리는 "평균과 분포"의 개념이 어떻게 LLM에서 작동하는지 알아보았습니다. 그래서 우리는 AI가 "오늘 점심은" 다음에 올 단어의 분포를 배운다는 것을 알게 되었습니다. "오늘 점심은" 뒤에 "뭐"가 30%, "맛있었다"가 25%, "김밥"이 8%…
그런데 분포를 안다고 해서 글이 저절로 써지지는 않습니다. 결국 하나를 골라야 다음 글자가 화면에 찍힙니다.
그 "고르기"가 어떻게 이루어지는지가 이번 글의 주제입니다. 그리고 그 답을 알면, 같은 질문에 ChatGPT나 Claude가 매번 조금 다른 답을 내놓는 이유도 저절로 풀립니다.
같은 질문을 두 번 해도 AI의 답은 조금씩 다릅니다. 고장이 아니라, 고르는 방식 때문입니다. (사진: Unsplash, Tim Witzdam)
그 답을 간단하게 요약하면,
AI는 지난 글에서 분포와 함께 나왔던 "비율"을 확률로 삼아, 칸의 크기가 제각각인 주사위를 굴려 다음 토큰을 고른다는 것입니다.
큰 칸("뭐" 30%)이 자주 나오지만 작은 칸("김밥" 8%)도 가끔 나옵니다. 그래서 흔한 답이 주로 나오되 매번 똑같지는 않습니다.
이 글에서는 확률이 무엇인지, AI가 어떻게 "확률대로" 고르는지, 그리고 왜 한 번에 한 조각씩 고르는지를 봅니다.
공정한 주사위와 불공정한 주사위
몇 가지 비유를 들어 쉽게 한번 이야기해보겠습니다. 보통 주사위는 여섯 눈이 똑같이 1/6씩 나옵니다. 어느 눈이 나올지 미리 알 수는 없지만, 1,000번 굴리면 각 눈이 대략 167번씩 나올 거라는 것은 압니다.
이것이 확률의 핵심 감각입니다.
"한 번은 모르지만, 많이 하면 비율은 안다." 라는 것이죠.
보통 주사위는 어느 눈이든 똑같이 1/6씩 나옵니다. AI의 주사위는 눈마다 크기가 다릅니다. (사진: Unsplash, Riho Kroll)
그럼 이제 눈마다 크기가 다른 주사위를 상상해 봅시다. 어떤 면은 넓고 어떤 면은 좁아서, 넓은 면이 바닥에 닿을 때가 훨씬 많습니다. 1,000번 굴리면 넓은 면은 300번, 좁은 면은 60번 나오는 식입니다.
AI가 쓰는 주사위가 바로 이런 불공정 주사위입니다. 다만 면의 개수가 6개가 아니라 수만 개(토큰 종류만큼)이고, 각 면의 크기는 지난 글에서 알아본 "분포"가 정해 줍니다.
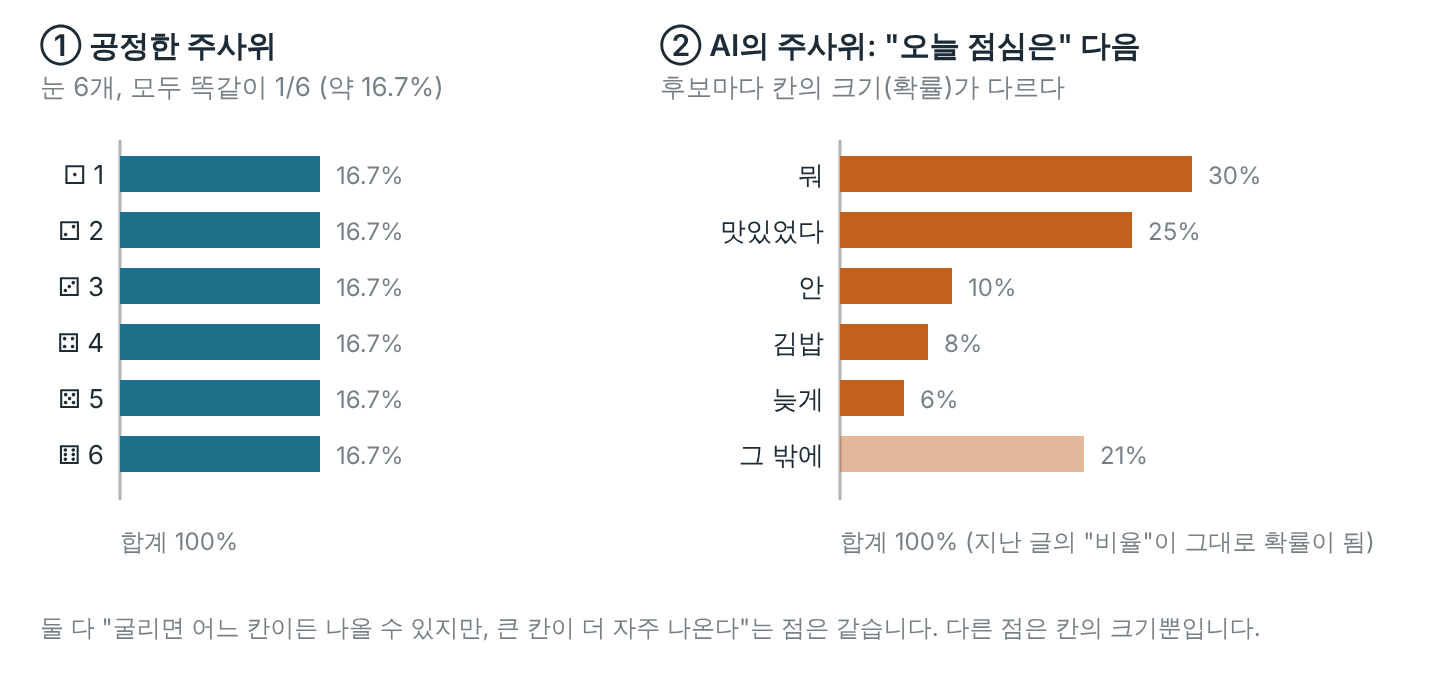
그림 1. 왼쪽은 보통 주사위, 오른쪽은 "오늘 점심은" 다음 토큰을 고르는 AI의 주사위입니다. 둘 다 합계는 100%이고, 둘 다 어느 칸이든 나올 수 있습니다. 다른 점은 칸의 크기뿐입니다.
제비뽑기 상자
또 다른 비유를 들어보겠습니다. 주사위보다 더 정확한 비유는 제비뽑기 상자입니다. 가상의 1,000문장 속에서 "오늘 점심은" 뒤에 올 단어의 분포대로 단어를 적은 쪽지 1,000장을 제비뽑기 상자에 넣습니다. "뭐" 300장, "맛있었다" 250장, "안" 100장, "김밥" 80장, "늦게" 60장, 그 밖의 단어 210장.
AI가 다음 단어를 고르는 일은 쪽지가 가득 든 상자에서 한 장을 뽑는 것과 닮았습니다. (사진: Unsplash, Obi)
상자를 흔들어 쪽지 한 장을 뽑으면 어떤 결과들을 우리는 예측할 수 있을까요?
-
"뭐"가 나올 가능성이 가장 큽니다 (1,000장 중 300장).
-
하지만 "김밥"이 나올 수도 있습니다 (80장이나 들어 있으니까).
-
상자에 한 장도 없는 단어("우주선")는 절대 나오지 않습니다.
AI가 다음 토큰을 고르는 일은 이 상자에서 쪽지 한 장을 뽑는 것과 같습니다. 그리고 뽑은 쪽지를 글 뒤에 붙인 다음, 새 상자(이제 "오늘 점심은 뭐" 뒤에 올 단어들이 담긴 상자)를 가져와 또 한 장을 뽑습니다. 이 과정을 글이 끝날 때까지 반복합니다.
Attention: * 실제 AI 안에 쪽지 상자가 들어 있는 것은 아닙니다. 앞의 글은 다양하게 나올 수 있고 그 상황은 사실상 거의 무한대로, 상자를 다 만들어 둘 수 없습니다. 대신 "앞의 글을 넣으면 각 후보의 확률을 계산해 내는 장치"(신경망)가 그때그때 상자의 내용물을 계산합니다. 또 실제 상자에는 쪽지가 0장인 단어가 거의 없고, 아주 드문 단어에도 아주 작은 확률이 붙어 있습니다. "절대 안 나오는 단어"보다는 "거의 안 나오는 단어"가 정확합니다. 이 차이가 환각과 관련이 있습니다. 신경망과 환각에 대해서는 다음의 회차들에서 다루어보겠습니다.
그림으로 보는 "확률대로 고르기"
이를 그림으로 보면 다음과 같습니다. 앞의 그림 1을 보면 눈이 여섯 가지가 있는 주사위는 어떤 칸이 나올지 예측하는 확률값이 각 칸마다 동일합니다. 하지만 칸의 크기가 다른 AI의 주사위는 어떤 칸이 나올지를 나타내는 확률값이 각 칸마다 다릅니다.
칸의 크기가 다른 AI 주사위를 그림 2와 같이 0에서 1까지 범위의 종이띠로 나타내면 더 정확한 비유가 됩니다. 0부터 1까지를 뒤에 올 단어의 각 후보의 확률만큼 잘라 칸을 만든 다음, 아무 수나 뽑아, 그 수가 떨어진 칸에 해당하는 단어가 그 뒤에 오는 것입니다. 물론 반복 횟수가 많아질수록 칸이 상대적으로 더 넓은 단어가 선택될 가능성이 커질 것입니다.
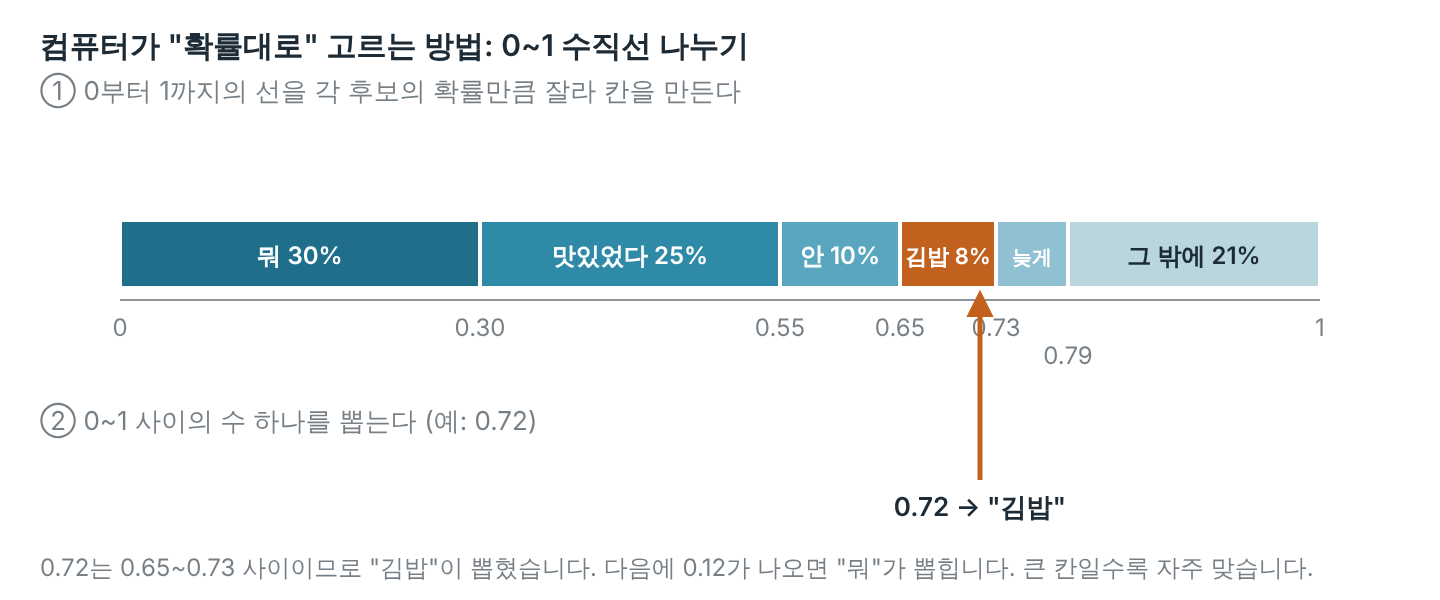
그림 2. 0부터 1까지의 선을 확률만큼 잘라 칸을 만들고, 0과 1 사이의 수 하나를 뽑아 그 수가 어느 칸에 떨어졌는지 봅니다. 0.72가 뽑히면 "김밥", 0.12가 뽑히면 "뭐"입니다.
실제 AI는 이렇게 글을 이어 만들어 가는 것입니다. 그리고 그림 3과 같이 단어가 나오면, 그 뒤에 이어질 단어를 다른 분포로 이루어진 주사위를 굴려서 칸을 뽑아 선택합니다. 또 뒤이어 또 다른 분포로 이루어진 주사위를 굴려서 칸을 뽑아 단어를 선택하며, 말이 끝날 때까지 이러한 과정을 이어가는 것입니다.
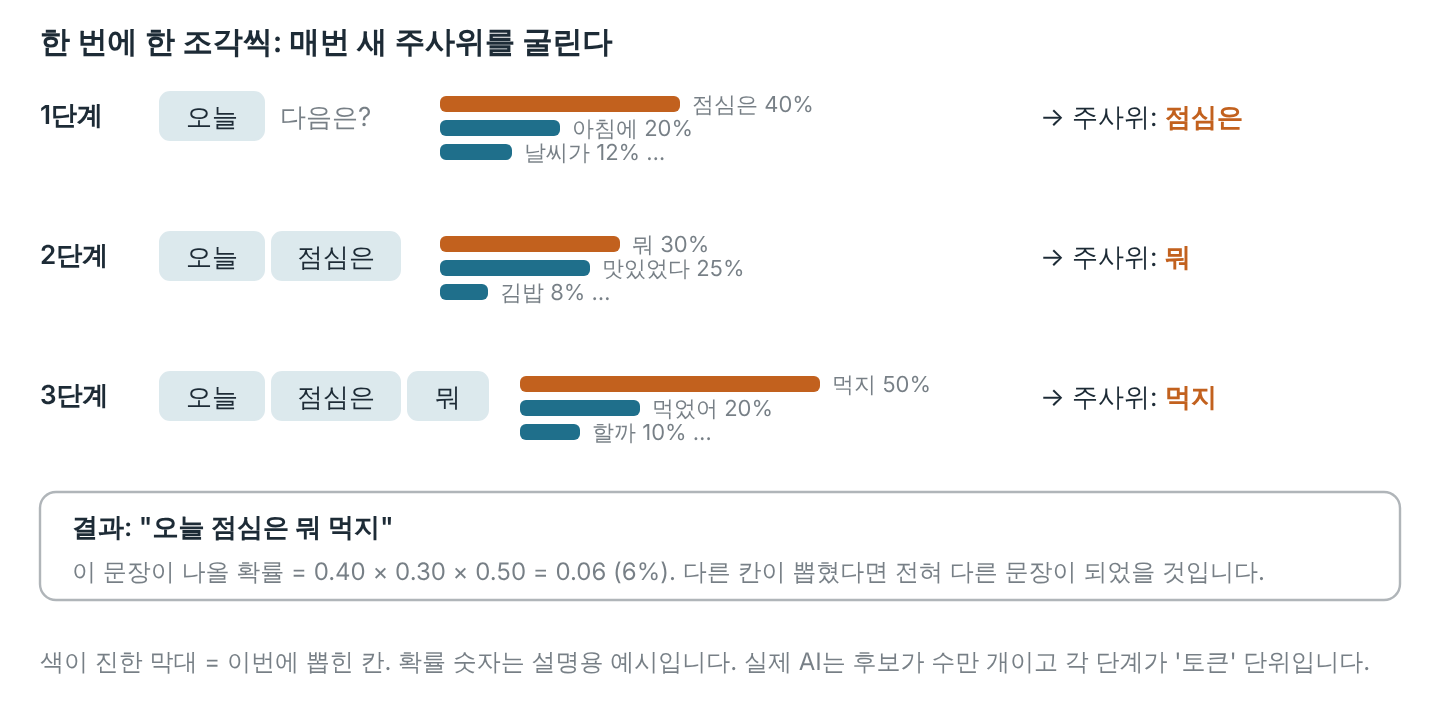
그림 3. "오늘"에서 시작해 "점심은"(40%), "뭐"(30%), "먹지"(50%)를 차례로 뽑아 문장이 완성됩니다. 단계마다 확률표가 새로 만들어지고 주사위도 새로 굴립니다.
그래서 그림의 문장 "오늘 점심은 뭐 먹지"가 완성되는 것이고, 이 문장이 나타날 확률은 6%가 되는 것입니다. 이 6%가 어떻게 나왔는지는 조금 뒤에 다시 보겠습니다.
확률 = 비율, 그리고 두 가지 규칙
조금 더 자세히 알아봅시다. 지난 글에서 활용했던 표를 다시 가져와 보겠습니다.
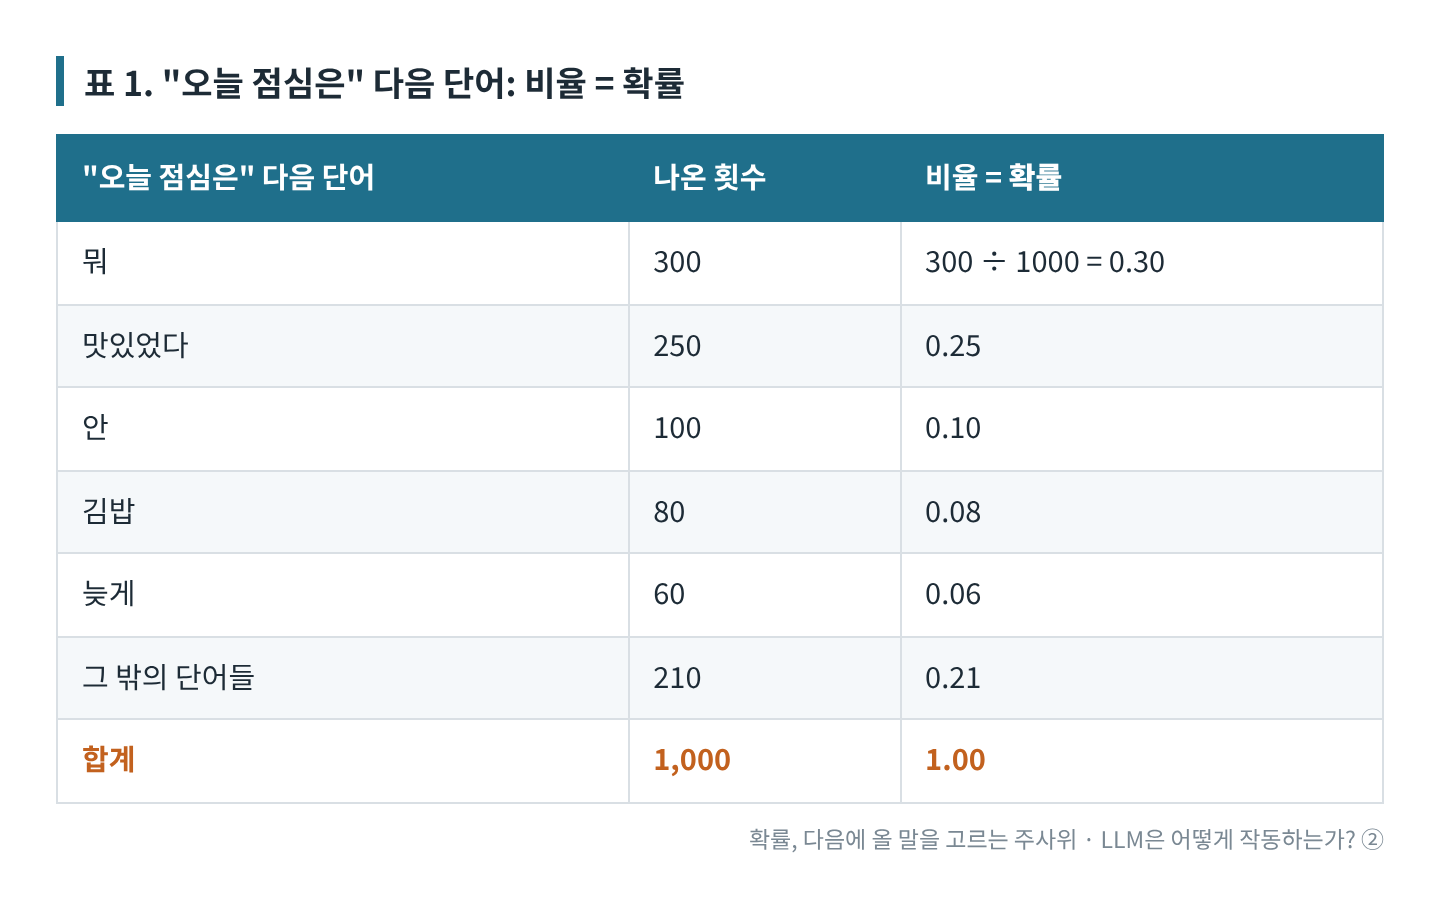
지난 글에서 "비율"이라고 부른 것을 이번 글부터 확률이라고 부릅니다. 뜻은 같습니다. "전체 중에서 그 경우가 차지하는 몫"입니다. 확률에는 규칙이 딱 두 가지 있습니다.
-
확률은 0과 1 사이의 수다. 0은 "절대 안 일어남", 1은 "반드시 일어남", 0.5는 "반반"입니다. 백분율로 쓰면 0%~100%입니다.
-
모든 경우의 확률을 더하면 꼭 1이다. 위 표의 오른쪽 열을 더해 보세요. 0.30 + 0.25 + 0.10 + 0.08 + 0.06 + 0.21 = 1.00. 뭔가 하나는 반드시 뽑히기 때문입니다.
이 두 번째 규칙이 중요합니다. 확률은 나눠 갖는 몫이라서, 어떤 후보의 확률이 올라가면 반드시 다른 후보의 확률이 내려갑니다. 전체 크기가 1로 고정된 파이를 나누는 것과 같습니다.
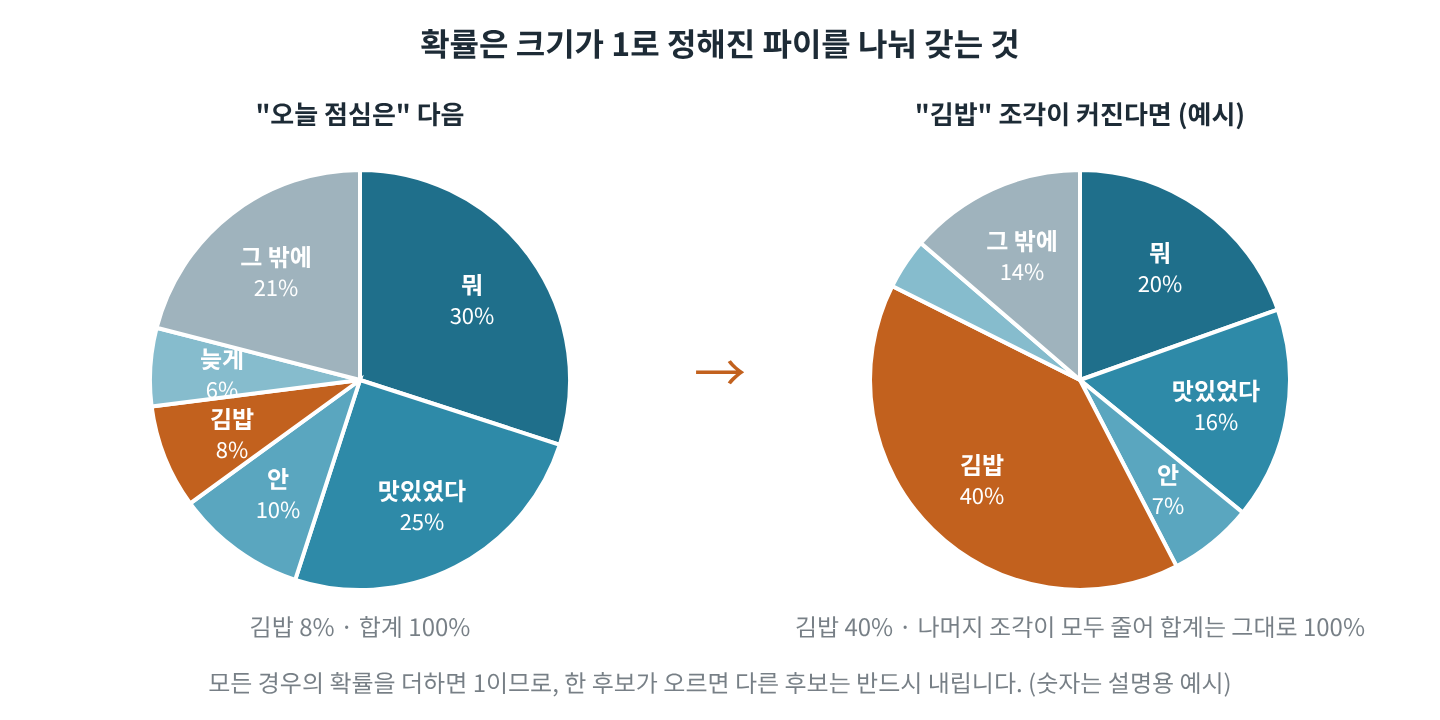
그림 4. "김밥" 조각이 8%에서 40%로 커지면, 나머지 조각이 모두 줄어 합계는 그대로 100%입니다. (숫자는 설명용 예시)
"김밥"의 확률이 올라가면 "뭐"의 확률이 내려가는 것은 바로 이 규칙 때문입니다.
AI가 확률대로 고르는 법: 0~1 수직선
그럼 AI 안에는 주사위가 없는데 어떻게 "확률대로" 고를까요? 앞서 보았던 그림 2가 그 방법입니다.
-
0부터 1까지의 수직선을 준비합니다.
-
각 후보의 확률만큼 선을 잘라 칸을 만듭니다. "뭐"는 0
0.30, "맛있었다"는 0.300.55, "안"은 0.550.65, "김밥"은 0.650.73, "늦게"는 0.730.79, 그 밖의 단어들은 0.791.00. -
AI에게 0과 1 사이의 수를 아무거나 하나 내놓게 합니다. (우리가 사용하는 거의 모든 프로그래밍 언어와 스프레드시트에 이 기능이 있습니다. 엑셀에도
RAND()함수로 구현되어 있습니다.) -
그 수가 떨어진 칸의 단어를 고릅니다.
왜 이게 "확률대로"일까요? 0과 1 사이의 수는 선 위 어디든 고르게 떨어집니다. 그런데 "뭐"의 칸은 선의 30%를 차지하고 "김밥"의 칸은 8%만 차지합니다. 그러니 1,000번 뽑으면 약 300번은 "뭐" 칸에, 약 80번은 "김밥" 칸에 떨어집니다. 넓은 칸이 자주 맞는 것입니다.
이렇게 수직선을 잘라 놓은 것이 곧 불공정 주사위이고, 0~1 사이의 수를 뽑는 것이 굴리기입니다. 직접 해 보면 더 와닿습니다. 아래는 뽑아 본 수 다섯 개입니다.
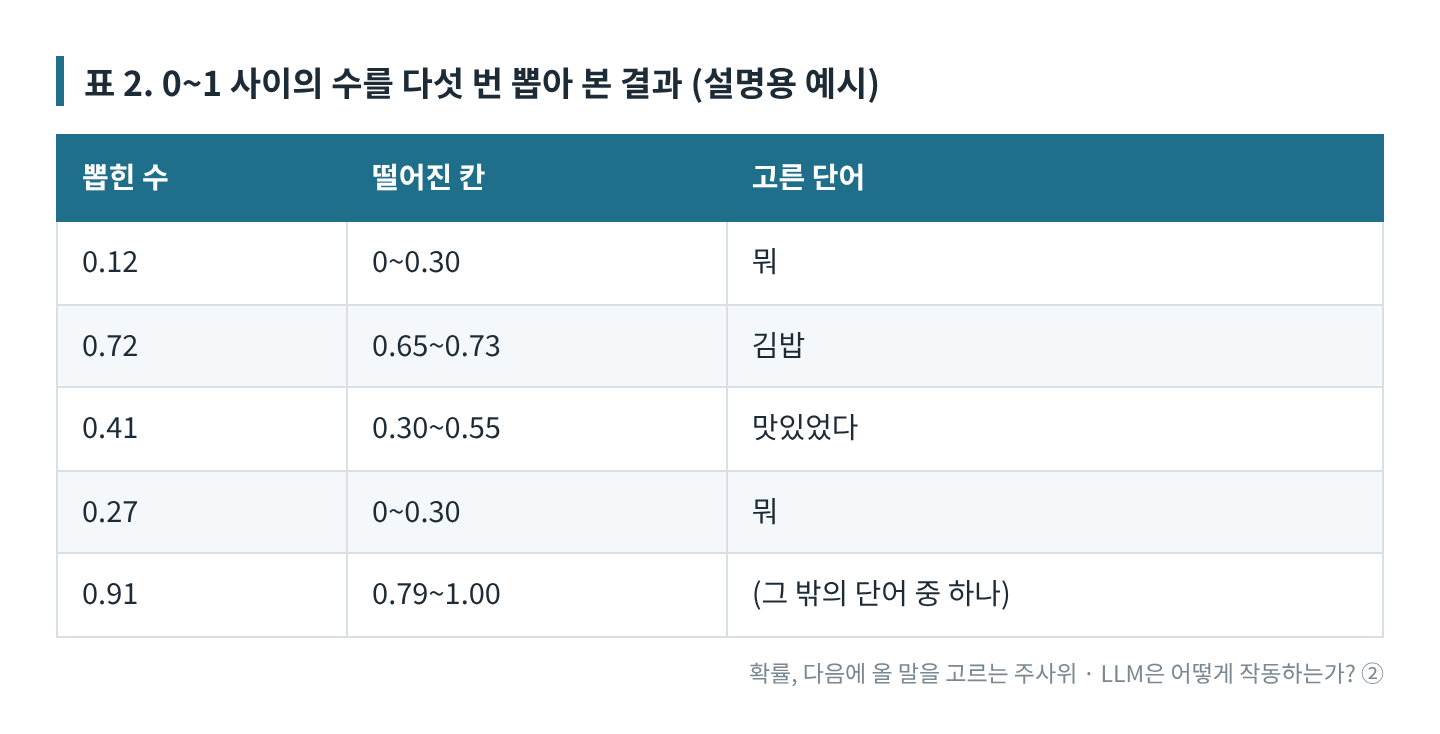
다섯 번 중 "뭐"가 두 번, 나머지가 한 번씩입니다. 횟수를 늘릴수록 30 : 25 : 10 : 8 : 6 : 21의 비율에 가까워집니다.
한 가지 덧붙이면, 컴퓨터가 내놓는 "아무 수"는 사실 진짜 우연이 아니라 계산으로 만들어 낸 가짜 우연(의사난수) 입니다. 시작값(씨앗, seed)을 똑같이 주면 똑같은 수가 똑같은 순서로 나옵니다. 우리가 쓰는 AI 서비스는 매번 다른 시작값을 쓰기 때문에 매번 다른 칸이 뽑힙니다.
확률은 "0과 1의 평균"이다
지난 글에서 "AI는 세상을 평균적으로 본다"고 했는데, 확률과 평균은 사실 같은 뿌리입니다. 이것을 알면 이후 회차들에서 알아볼 "학습"이 훨씬 쉬워지므로 여기서 미리 짚어 둡니다.
앞서 보았던 "오늘 점심은" 뒤에 올 단어에 대해, 1,000문장 속에서 "김밥"이 나온 횟수는 80이었습니다. 이제 각 문장마다 "다음 단어가 김밥이면 1, 아니면 0"이라고 적어 봅시다. 그러면 1이 80개, 0이 920개입니다. 그리고 이 숫자들의 평균은 다음과 같이 나옵니다.
(1 × 80 + 0 × 920) ÷ 1000 = 80 ÷ 1000 = 0.08
"김밥"의 확률 0.08과 정확히 같습니다. 우연이 아닙니다. 확률이란 "일어나면 1, 안 일어나면 0"을 적어 놓고 낸 평균입니다. 여기서 평균의 개념과 확률의 개념은 이어집니다.
이를 좀 더 설명해보자면, "다음에 올 단어가 김밥일 확률"을 하나의 숫자로 찍어야 한다면, 가장 덜 틀리는 숫자가 바로 0.08이라는 것입니다. 우리가 찍은 값을 p라고 하겠습니다. 1,000문장을 하나씩 보면서 "얼마나 틀렸나"를 잽니다. 틀린 정도, 즉 오차는 (정답 − p)를 제곱해서 잽니다.
-
다음 단어가 김밥인 문장(정답 1) 하나의 오차: (1 − p)². 이런 문장이 80개 있습니다.
-
다음 단어가 김밥이 아닌 문장(정답 0) 하나의 오차: (0 − p)² = p². 이런 문장이 920개 있습니다.
이를 식으로 나타내면 다음과 같습니다.
오차 합계 = [(1 − p)² × 80] + [(0 − p)² × 920]
예를 들어 p = 0.1로 찍으면, 김밥 문장 하나의 오차는 0.9 × 0.9 = 0.81이고 80개면 64.8입니다. 김밥이 아닌 문장 하나의 오차는 0.1 × 0.1 = 0.01이고 920개면 9.2입니다. 합계는 74.0입니다. 이런 식으로 p를 바꿔 가며 계산하면 다음 표가 나옵니다.
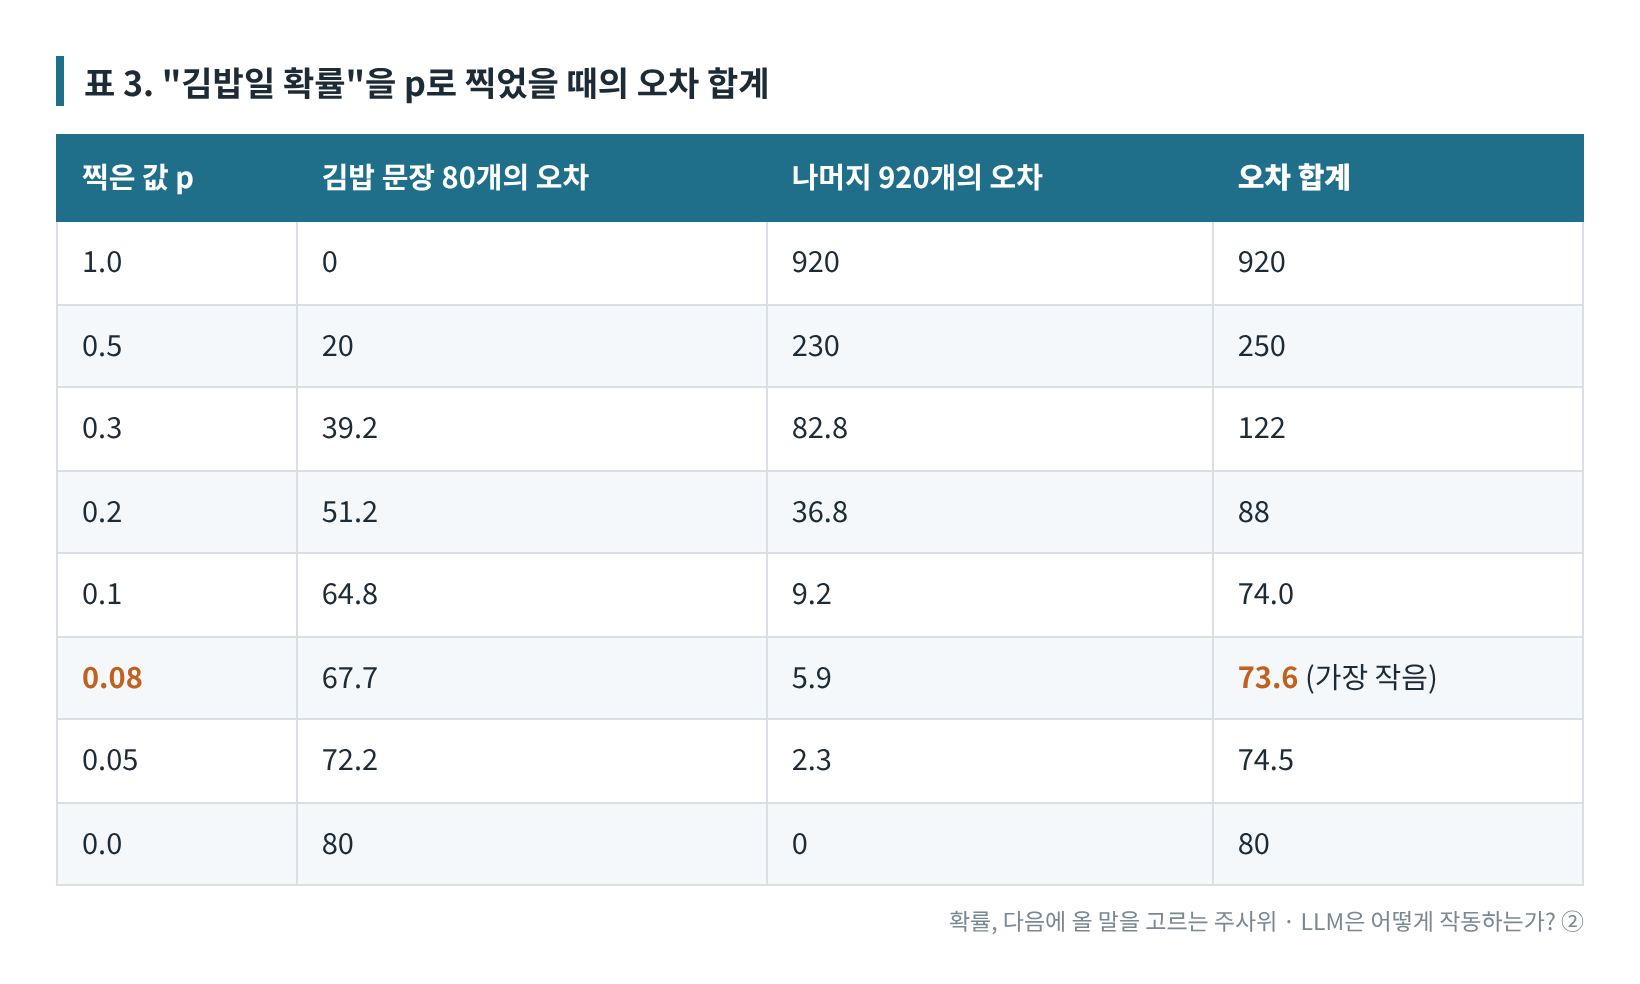
표를 위에서부터 읽어 보면 이야기가 보입니다. p = 1.0("무조건 김밥")으로 찍으면 김밥 문장 80개는 다 맞히지만 나머지 920개에서 크게 틀려 합계가 920입니다. p = 0.0("절대 김밥 아님")으로 찍으면 920개는 다 맞히지만 김밥 문장 80개에서 틀려 합계가 80입니다.
두 극단 사이에서 p를 줄여 가면 합계가 점점 작아지다가, 0.08에서 가장 작아지고 그보다 더 줄이면 다시 커집니다. 가장 덜 틀리는 값이 정확히 80 ÷ 1000, 즉 김밥 쪽지가 상자에서 차지하는 몫입니다.
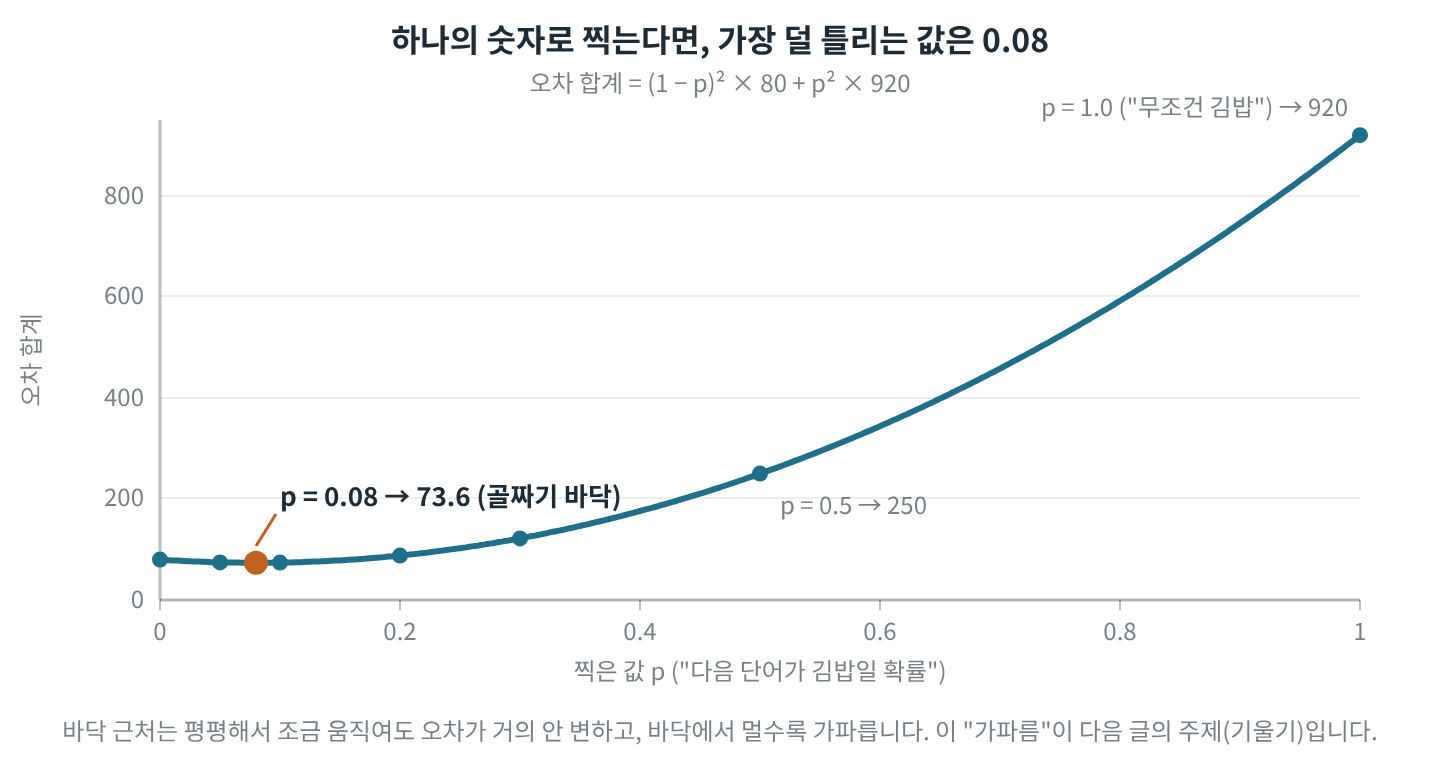
그림 5. 표의 숫자를 곡선으로 그리면 골짜기 모양이 됩니다. 바닥(가장 덜 틀리는 곳)이 바로 p = 0.08입니다.
정리하면 세 가지가 같은 숫자입니다.
-
1,000문장 중 김밥이 나온 비율: 80 ÷ 1000 = 0.08
-
"김밥이면 1, 아니면 0"을 적어 낸 평균: 0.08
-
하나의 숫자로 찍을 때 제곱 오차 합계를 가장 작게 만드는 값: 0.08
AI는 정답을 미리 알지 못한 채 p를 조금씩 고쳐 가며 오차 합계를 줄여 나가는 것입니다. 그렇게 끝까지 줄이면 도착하는 곳이 바로 0.08, 즉 확률입니다. "오차를 줄이는 학습"과 "확률을 배우는 것"이 같은 일이 되는 이유가 여기에 있습니다.
Attention: * 0.1(74.0), 0.08(73.6), 0.05(74.5)처럼 가장 작은 값 근처에서는 합계 차이가 아주 작습니다. 골짜기의 바닥이 평평하기 때문입니다. 반대로 1.0이나 0.5처럼 바닥에서 먼 곳에서는 조금만 움직여도 합계가 크게 변합니다. "얼마나 가파른가"를 재는 이 감각이 다음 회차의 주제인 기울기입니다.
상황이 바뀌면 확률표가 바뀐다
지난 글에서 "앞의 글이 바뀌면 분포도 바뀐다"고 했습니다. 확률로 말하면 이렇습니다.
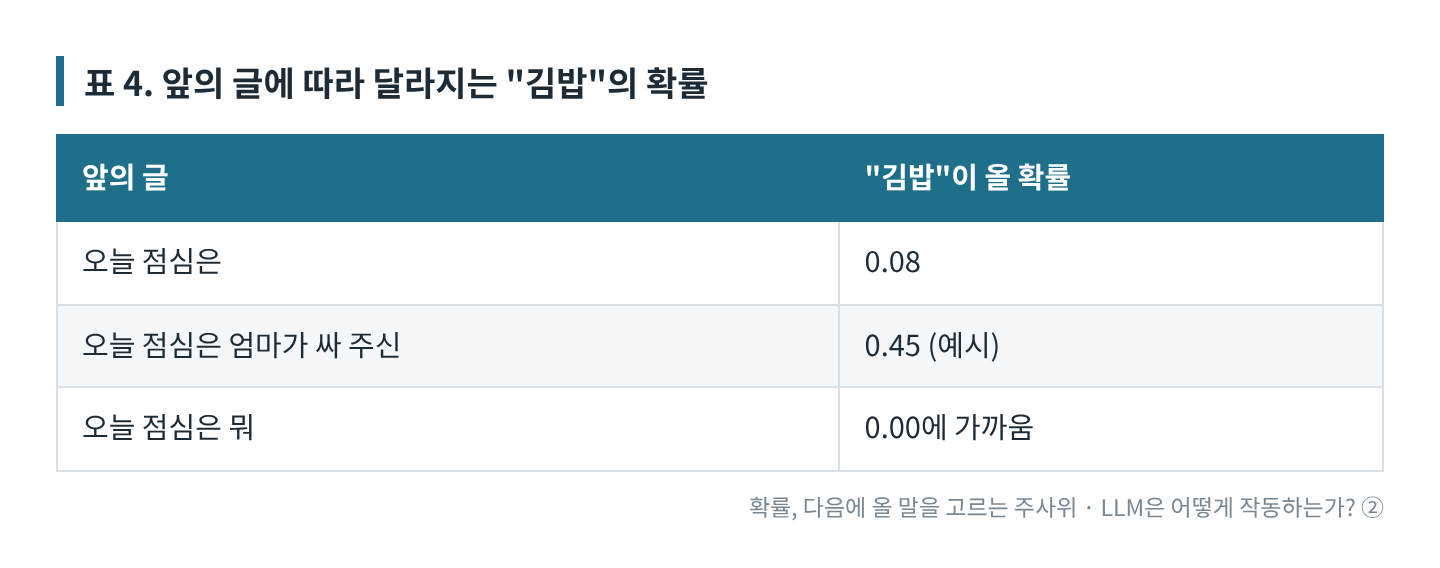
같은 "김밥"인데 앞의 글에 따라 확률이 8%였다가 45%였다가 거의 0이 됩니다. 수학에서는 이것을 "앞의 글이 주어졌을 때 김밥이 올 확률"이라고 부르고, 짧게 P(김밥 | 오늘 점심은)처럼 씁니다. 세로줄 "|"은 "~가 주어졌을 때"라는 뜻입니다.
이 표기는 외우지 않아도 되지만, AI 논문에 수없이 나오므로 눈에 익혀 두면 좋습니다. 핵심은 하나입니다.
AI가 다루는 확률은 언제나 "앞의 글이 주어졌을 때"의 확률입니다.
그래서 그림 3처럼 토큰을 하나 고를 때마다 확률표를 새로 만들어야 합니다.
한 번에 한 조각씩 고르는 이유, 그리고 확률의 곱
그림 3에서 AI는 "오늘 점심은 뭐 먹지"를 한 번에 만들지 않고 토큰을 하나씩 뽑아 붙였습니다. 그렇다면 왜 문장을 통째로 뽑지 않을까요?
통째로 뽑으려면 "가능한 모든 문장"을 후보로 놓고 각각에 확률을 매겨야 합니다. 그런데 토큰 종류가 5만 개이고 문장이 토큰 10개짜리라면, 첫 칸에 5만 가지, 둘째 칸에 5만 가지… 이렇게 칸마다 5만 가지씩 고를 수 있으므로, 가능한 문장의 수는 5만을 열 번 곱한 수입니다. (4자리 자물쇠의 비밀번호가 0~9까지의 10을 네 번 곱해 10,000가지인 것과 같은 원리입니다.)
계산하면 약 9.8 × 10⁴⁶, 1 뒤에 0이 46개쯤 붙는 수입니다. 1초에 1조 개씩 확률을 매긴다 해도 약 3 × 10²⁷년이 걸립니다. 이러한 방식으로는 아무리 AI라고 하더라도 불가능에 가까운 것입니다. 반면 한 조각씩 고르면 매 단계 후보가 5만 개뿐이라 충분히 할 만합니다.
그 대신 재미있는 성질이 생깁니다. 그림 3의 문장이 나올 확률은 각 단계 확률의 곱입니다.
0.40 (점심은) × 0.30 (뭐) × 0.50 (먹지) = 0.06
각 단계에서 가장 흔한 것을 골랐는데도 문장 전체의 확률은 6%밖에 안 됩니다. 1보다 작은 수는 곱할수록 작아지기 때문입니다. 긴 글일수록 "정확히 그 글"이 나올 확률은 0에 가까워집니다.
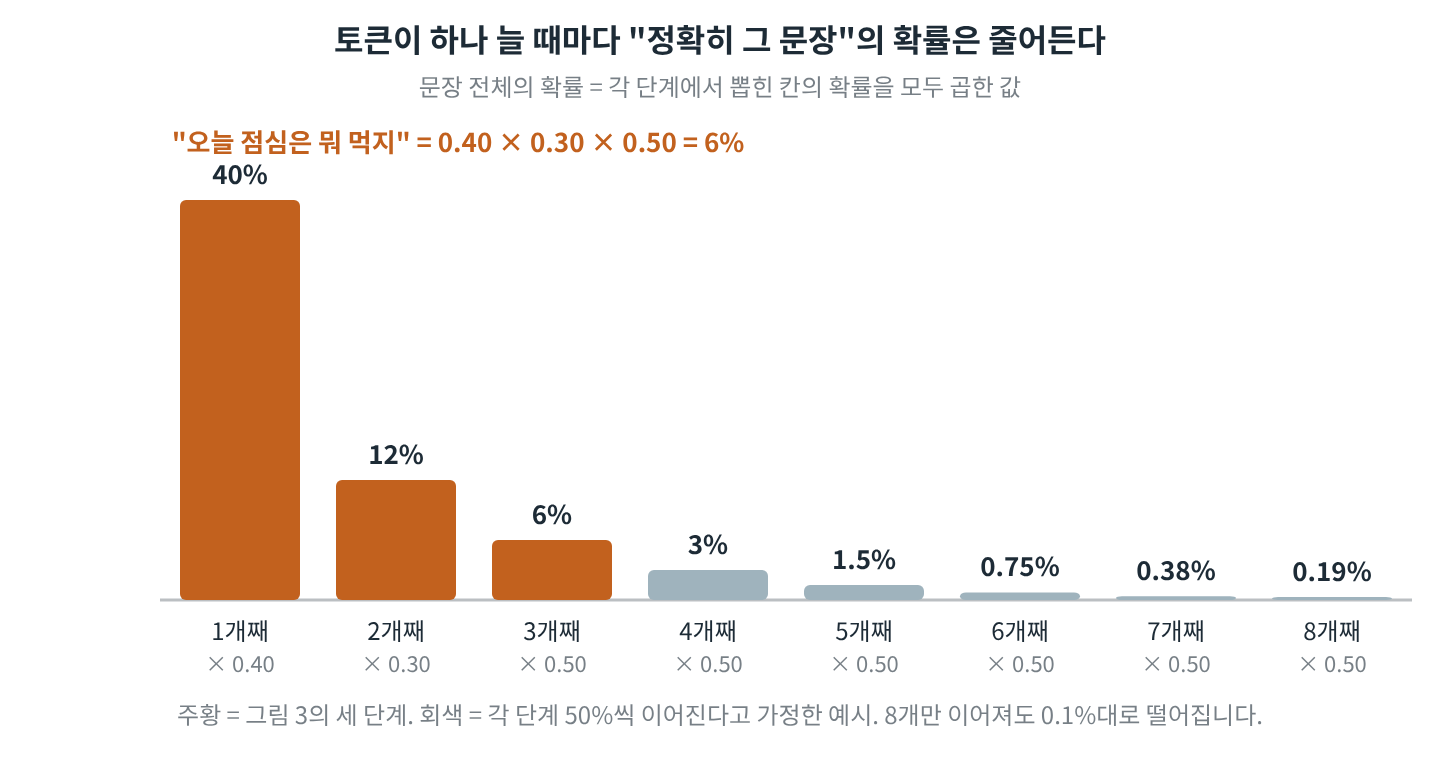
그림 6. 문장 전체의 확률은 각 단계 확률의 곱입니다. 토큰이 하나 늘 때마다 "정확히 그 문장"이 나올 확률은 줄어듭니다. (4개째부터는 각 단계 50%로 가정한 예시)
그래서 AI에게 같은 질문을 두 번 하면 긴 답일수록 토씨까지 똑같을 가능성이 거의 없습니다.
첫 토큰부터 마지막 토큰까지 주사위가 수백 번 굴러가는 동안 한 번만 다른 칸에 떨어져도 그 뒤는 다른 길로 가기 때문입니다.
그렇다면 우리는 이 단계에서 이렇게 질문할 수 있을 것입니다. "그냥 확률이 가장 높은 것만 고르면 되지 않나?" 그렇게 할 수도 있습니다. 매 단계 1등만 고르면 같은 질문에 항상 같은 답이 나옵니다. 하지만 두 가지 대가가 있습니다.
첫째, 1등끼리만 이어 붙인 문장이 전체적으로 가장 자연스러운 문장이라는 보장이 없습니다. 지금 1등을 고르면 다음 단계의 선택지가 나빠질 수도 있습니다.
둘째, 글이 단조롭고 반복적이 되기 쉽습니다. "좋은 하루 되세요. 좋은 하루 되세요. 좋은 하루 되세요…"처럼 같은 말이 맴도는 현상이 생기곤 합니다. 이는 LLM 분야에서 널리 알려진 현상입니다. 2020년 발표된 홀츠먼(Holtzman) 연구팀의 논문은 매 단계 확률이 가장 높은 후보만 고르면 글이 반복적이고 단조로워진다는 것을 분석했습니다.
그래서 대부분의 AI 서비스는 1등만 고르지 않고 확률대로 주사위를 굴리되, 큰 칸이 더 잘 나오도록 조절합니다. 이 "조절 손잡이"가 온도(temperature) 인데, 자세한 것은 다음 회차들에서 다루겠습니다.
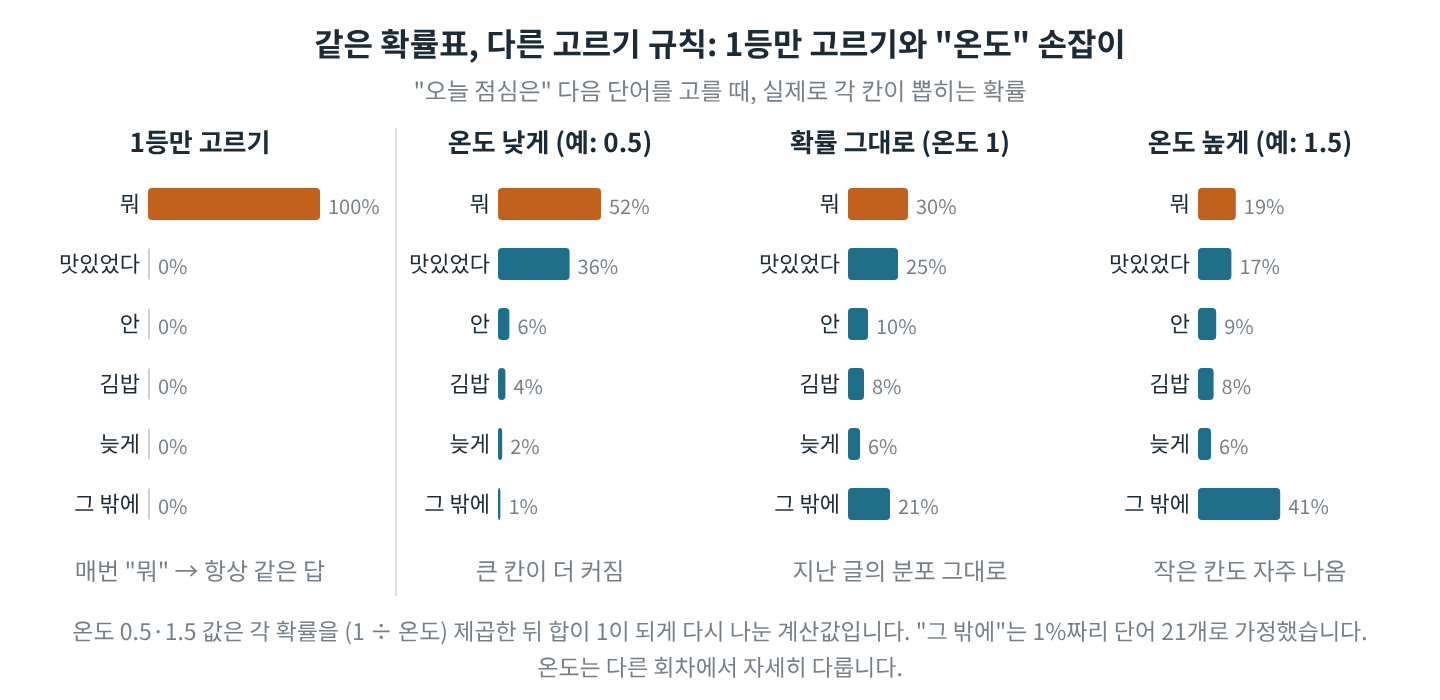
그림 7. 같은 확률표라도 고르는 규칙에 따라 실제로 뽑히는 비율이 달라집니다. 온도를 낮추면 큰 칸이 더 커지고, 높이면 작은 칸도 자주 나옵니다.
실제 AI에서는
이렇게 ChatGPT, Gemini, Claude, Grok, DeepSeek을 비롯한 LLM은 모두
"앞의 글이 주어졌을 때 다음 토큰의 확률"을 계산하고, 그 확률에 따라 토큰 하나를 고르고, 붙이고, 반복합니다.
이 방식은 특정 회사의 비밀이 아니라 LLM이라는 기술의 정의에 가깝습니다. 그림 3이 보여 주는 과정이 모든 대표 AI 안에서 매 글자마다 일어납니다.
이 발상의 뿌리는 깊습니다. 1948년 클로드 섀넌은 영어 글자와 단어의 통계를 모아 놓고 확률대로 뽑아 문장을 만드는 실험을 했습니다. 글자를 하나씩 확률대로 뽑으면 "ON IE ANTSOUTINYS ARE T INCTORE…" 같은 영어 비슷한 무의미한 글이 나왔습니다. 단어 단위로 "앞 단어가 주어졌을 때 다음 단어"의 확률을 쓰면 "THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER…"처럼 꽤 영어다운 문장이 나왔습니다.
다만, 섀넌은 손으로 세고 책을 뒤져 뽑았습니다. 오늘날 LLM은 같은 일을 수천억 개의 가중치로 계산한 훨씬 정교한 확률표로 하고 있습니다. 즉 그 사이 70여 년 동안 바뀐 것은 확률표의 품질이지, "확률대로 다음 조각을 뽑는다"는 틀은 동일한 것입니다.
이것이 바로 우리가 LLM 시대에 분포와 확률 등 고전적 수학의 원리를 알아야 하는 이유이기도 합니다. AI를 움직이는 원리는 변하지 않았습니다.
우리는 공개된 AI 서비스들의 문서를 통해 앞서 알아본 원리들이 AI에 적용되었음을 알 수 있습니다.
-
확률을 직접 보여 주는 기능: OpenAI의 개발자용 API에는 각 토큰 위치에서 가장 확률이 높았던 후보 토큰들과 그 확률을 함께 돌려주는 옵션(logprobs, top_logprobs)이 있습니다. 즉 그림 3의 막대그래프를 실제 모델에서 숫자로 꺼내 볼 수 있는 것입니다. "AI는 다음 토큰의 확률을 계산한다"는 말이 비유가 아니라는 가장 직접적인 증거입니다.
-
조절 손잡이(온도): Anthropic 문서는 Claude의 온도를 0.0~1.0, 기본값 1.0으로 안내하며 "0.0에 가까울수록 분석형·객관식 작업에, 1.0에 가까울수록 창작형 작업에" 쓰라고 설명합니다. 그리고 온도 0.0에서도 결과가 완전히 똑같지는 않다고 명시합니다.
-
세대에 따라 바뀌는 정책: 같은 문서는 Claude Opus 4.6 이후에 출시된 모델에서는 온도를 직접 설정할 수 없다고(기본값 1.0만 허용) 밝히고 있습니다. 설정 범위와 정책이 모델 세대에 따라 바뀐다는 것을 보여 줍니다.
-
회사마다 다른 범위: OpenAI의 API 문서는 온도를 0
2 범위로, Google의 Gemini API 문서는 GenerationConfig에서 0.02.0 범위로 안내합니다(모델에 따라 상한은 다를 수 있습니다). 숫자 범위는 회사마다 다르지만 "온도가 낮을수록 큰 칸을 더 자주, 높을수록 작은 칸도 자주"라는 뜻은 같습니다.
다만 우리가 웹이나 앱에서 쓰는 ChatGPT·Gemini·Claude 채팅 서비스가 내부적으로 어떤 온도와 어떤 뽑기 규칙을 쓰는지는 공개되지 않았습니다. 또한, 개발자용 API의 기본값이 채팅 서비스에도 그대로 적용된다고 단정할 수는 없습니다.
그래서 발견한 AI의 성격
지금까지 살펴본 "확률대로 한 조각씩 뽑는다"는 사실에서 우리는 AI의 성격 몇 가지를 발견할 수 있습니다.
-
같은 질문에 다른 답이 나옵니다. 주사위를 굴리므로 당연합니다. 고장이 아니라 설계입니다. 같은 답을 원하면 온도를 낮추면 되지만, 그래도 완전히 같지는 않을 수 있다고 Anthropic 문서도 밝히고 있습니다.
-
드문 답도 가끔 나옵니다. "김밥"에 해당하는 8%짜리 칸도 열두 번에 한 번꼴로 뽑힙니다. 그래서 가끔 뜻밖의 표현이나 뜻밖의 실수가 나옵니다.
-
앞부분이 뒷부분을 끌고 갑니다. 2단계에서 "김밥"이 뽑히면 3단계부터는 김밥 이야기로 흘러갑니다. 초반의 작은 선택이 전체 글의 방향을 바꿉니다. 사람이 글을 쓸 때 "일단 첫 문장을 쓰면 다음이 따라 나온다"는 것과 닮았지만, AI는 뒤로 돌아가 고치지 않고 오직 앞으로만 뽑아 나간다는 점이 다릅니다.
-
확률이 높다고 옳은 것은 아닙니다. 확률은 "인터넷 글에서 이 다음에 이 말이 얼마나 자주 왔는가"일 뿐입니다. 그래서 자주 쓰인 틀린 말이 높은 확률로 뽑힐 수 있는 것입니다. 그렇기 때문에 우리는 AI가 내어놓은 답변을 항상 검증해봐야 합니다. 최종 결정은 항상 인간의 몫입니다.
첫 도미노가 어느 쪽으로 넘어지느냐가 나머지를 정하듯, 초반에 뽑힌 토큰이 글 전체의 방향을 끌고 갑니다. (사진: Unsplash, Robert Stump)
Attention: * 위 네 가지는 원리에서 끌어낸 해석입니다. 실제 모델이 어느 정도 그런지는 모델·버전·설정에 따라 다릅니다.
그럼 지금까지 이야기한 내용을 통해 우리가 흔히 오해할 수 있는 부분을 다음과 같이 정리해보겠습니다.
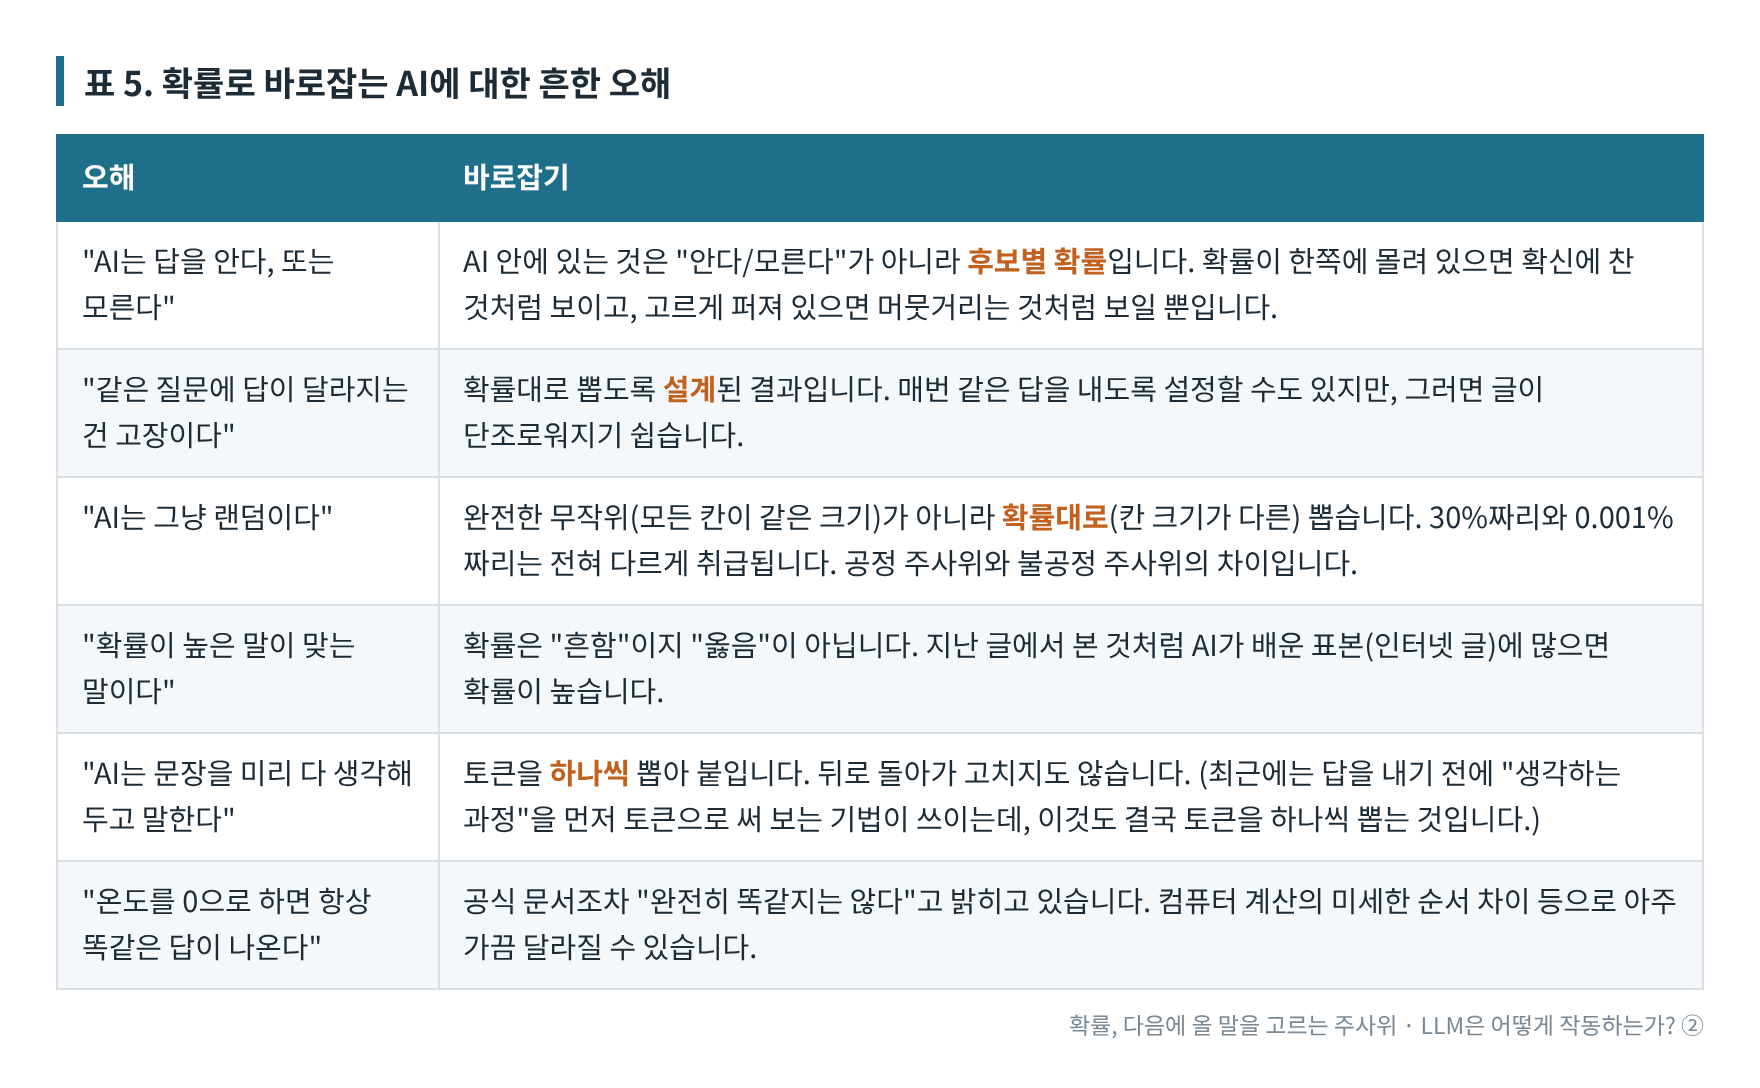
마지막으로 이번 글의 핵심을 다음의 세 문장으로 요약합니다.
-
확률은 비율이고, 0과 1 사이이며, 모두 더하면 1이다. 그래서 한 후보가 오르면 다른 후보는 반드시 내린다.
-
AI는 다음 토큰을 "확률대로 뽑는다." 큰 칸이 자주, 작은 칸이 가끔. 그래서 흔한 답이 주로 나오되 매번 같지는 않다.
-
한 번에 한 조각씩, 앞의 글이 주어졌을 때의 확률로 뽑고, 뒤로 돌아가지 않는다. 긴 답일수록 똑같이 나올 확률은 0에 가깝다.
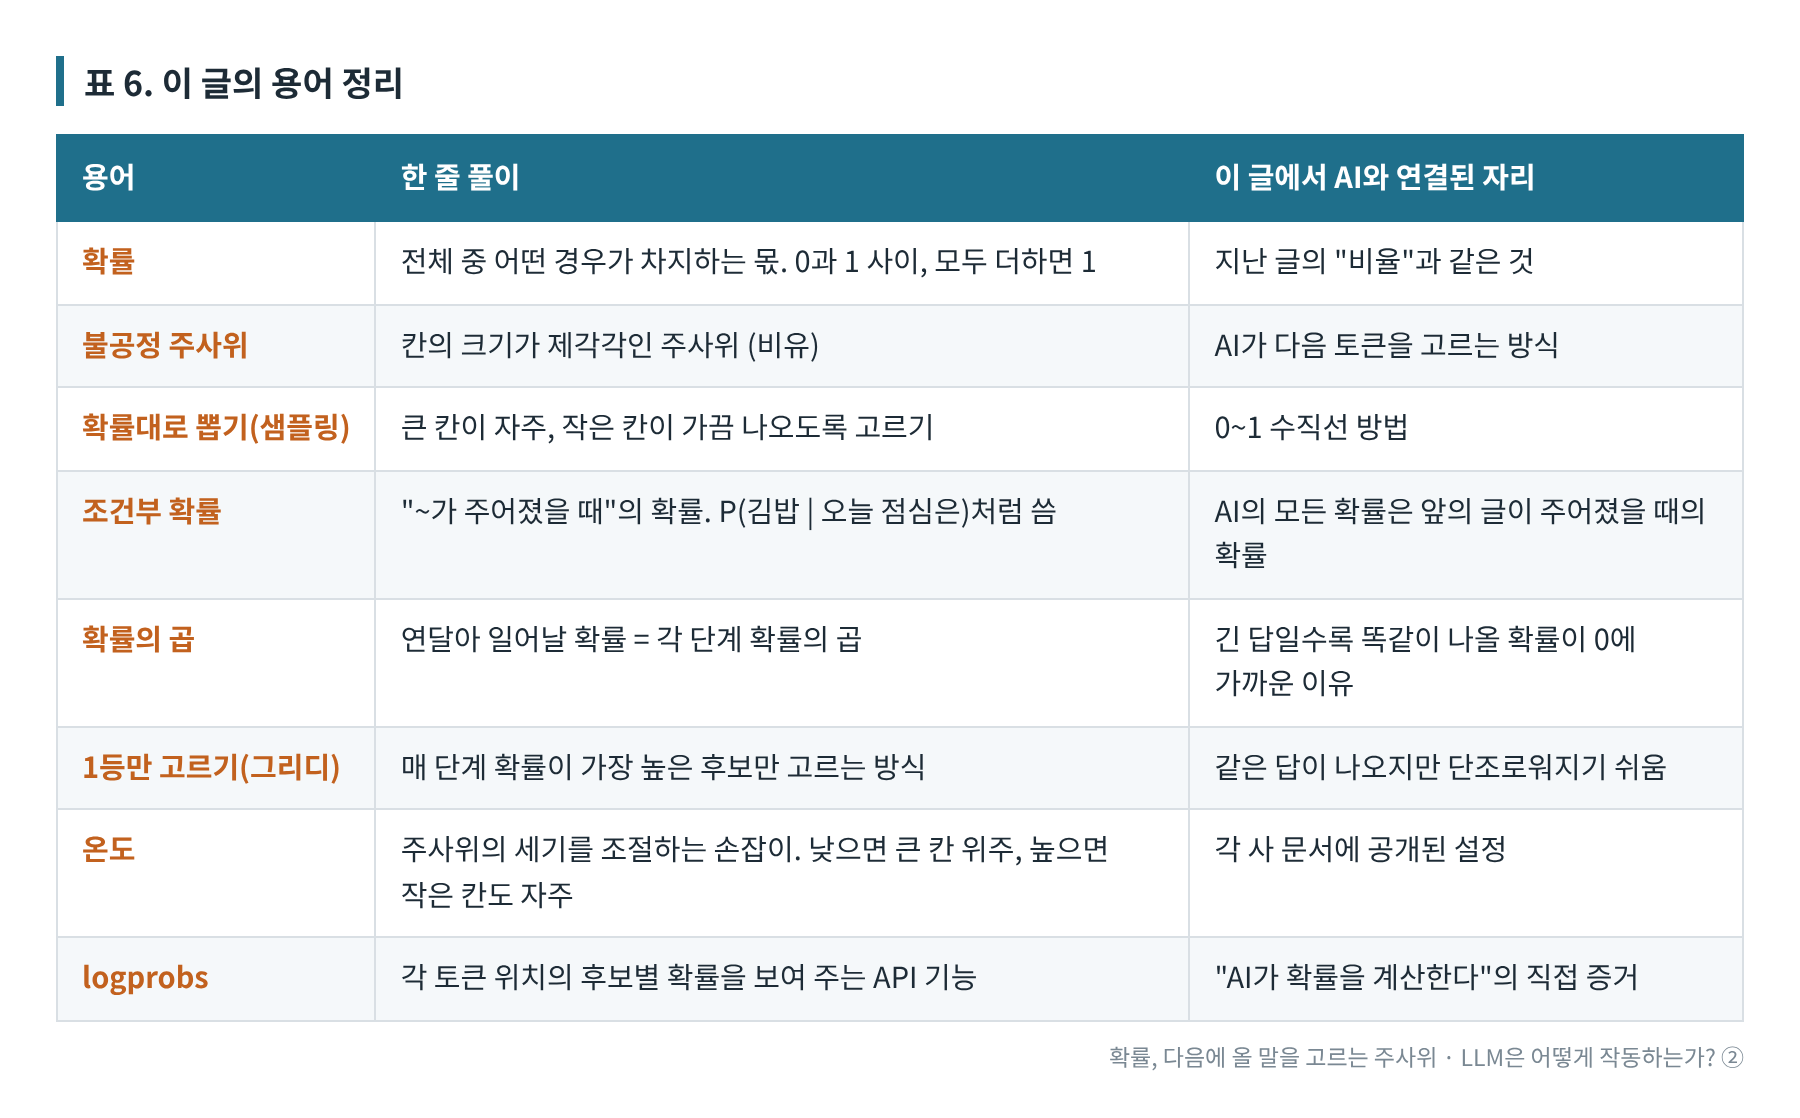
용어 정리
출처 정보
-
A. Holtzman et al., The Curious Case of Neural Text Degeneration, ICLR 2020
-
C. E. Shannon, A Mathematical Theory of Communication, Bell System Technical Journal, 1948
-
OpenAI, API Reference
-
Anthropic, Claude Platform Docs
-
Google, Gemini API Reference
Newsletter
이런 노트를 이메일로 받아보세요
새로운 리서치 노트가 발행되면 가장 먼저 알려드립니다.